阅读笔记
DAPO: An Open Source LLM Reinforcement Learning System at Scale
DAPO 的首要贡献是把解耦裁剪、动态采样、token 级策略梯度聚合和超长奖励整形组织为一条可复现的长思维链强化学习流程,在 Qwen2.5-32B Base 与 AIME 2024 设置中将朴素 GRPO 的 avg@32 从 30 提高到 50,并开源代码、17K 训练数据与模型;该结果来自单一主模型、单一主要基准和逐阶段开发实验,当前官方复现包中完整配置与移除动态采样配置分别得到 52 和 50。
所读版本 proceedings paper;arXiv v2;verl recipe commit 52cdedf7e0cfbc3b7d518faefcb2035b12f689f4;paper reproduction core verl commit 4f80e465c2ec79ab9c3c30ec74b9745de61d0490
Source
- Workflow version: v2.1
- Material type: research-paper
- Analysis modules: experiment, system
- Canonical source: https://proceedings.neurips.cc/paper_files/paper/2025/hash/a4277440d50f1f15d2cb4c14f7e0c0d2-Abstract-Conference.html
- Title: DAPO: An Open-Source LLM Reinforcement Learning System at Scale
- Authors: Qiying Yu, Zheng Zhang, Ruofei Zhu, Yufeng Yuan, Xiaochen Zuo, Yu Yue, Weinan Dai, Tiantian Fan, Gaohong Liu, Juncai Liu, Lingjun Liu, Xin Liu, Haibin Lin, Zhiqi Lin, Bole Ma, Guangming Sheng, Yuxuan Tong, Chi Zhang, Mofan Zhang, Ru Zhang, Wang Zhang, Hang Zhu, Jinhua Zhu, Jiaze Chen, Jiangjie Chen, Chengyi Wang, Hongli Yu, Yuxuan Song, Xiangpeng Wei, Hao Zhou, Jingjing Liu, Wei-Ying Ma, Ya-Qin Zhang, Lin Yan, Yonghui Wu, Mingxuan Wang
- Responsible organization: ByteDance Seed; Institute for AI Industry Research, Tsinghua University; The University of Hong Kong; SIA-Lab of Tsinghua AIR and ByteDance Seed
- arXiv: https://arxiv.org/abs/2503.14476
- PDF: https://proceedings.neurips.cc/paper_files/paper/2025/file/a4277440d50f1f15d2cb4c14f7e0c0d2-Paper-Conference.pdf
- Code/Project: https://github.com/verl-project/verl-recipe/tree/main/dapo
- Project page: https://dapo-sia.github.io/
- Wrapper repository: https://github.com/BytedTsinghua-SIA/DAPO
- Data: https://huggingface.co/datasets/BytedTsinghua-SIA/DAPO-Math-17k
- Model: https://huggingface.co/BytedTsinghua-SIA/DAPO-Qwen-32B
- OpenReview / Review page: https://openreview.net/forum?id=2a36EMSSTp
- Submitted: 2025-03-18
- Published / updated: NeurIPS 2025;arXiv v2 updated 2025-05-20
- Current version read: NeurIPS 2025 camera-ready proceedings paper, checked against arXiv v2 and the official DAPO reproduction package
- Version / revision read: proceedings paper;arXiv v2;
verl-recipecommit52cdedf7e0cfbc3b7d518faefcb2035b12f689f4;paper reproduction coreverlcommit4f80e465c2ec79ab9c3c30ec74b9745de61d0490 - Accessed: 2026-08-04
- Key figure decision: include
- Review status: page-type=official-review; match-confidence=high; observed-at=2026-08-04; venue-status=accepted-poster
- Subjects: Machine Learning; Computation and Language
作者与关系
- Qiying Yu: ByteDance Seed;Institute for AI Industry Research (AIR), Tsinghua University;SIA-Lab of Tsinghua AIR and ByteDance Seed。
- Zheng Zhang: ByteDance Seed。
- Ruofei Zhu、Yufeng Yuan、Xiaochen Zuo、Yu Yue、Tiantian Fan、Gaohong Liu、Juncai Liu、Lingjun Liu、Xin Liu、Haibin Lin、Zhiqi Lin、Bole Ma、Chi Zhang、Mofan Zhang、Ru Zhang、Wang Zhang、Hang Zhu、Jinhua Zhu、Jiaze Chen、Chengyi Wang、Xiangpeng Wei、Yonghui Wu: ByteDance Seed。
- Weinan Dai、Yuxuan Tong、Hongli Yu、Yuxuan Song: ByteDance Seed;AIR, Tsinghua University;SIA-Lab。
- Guangming Sheng: ByteDance Seed;The University of Hong Kong。
- Jiangjie Chen、Lin Yan、Mingxuan Wang: ByteDance Seed;SIA-Lab。
- Hao Zhou、Jingjing Liu、Wei-Ying Ma、Ya-Qin Zhang: AIR, Tsinghua University;SIA-Lab。
论文首页将 Qiying Yu 与 Zheng Zhang 标为共同第一作者,将 Weinan Dai 至 Jinhua Zhu 标为同等工程贡献,并将 Hao Zhou 与 Mingxuan Wang 标为通讯作者。作者关系以最终 proceedings 作者块为准;它相较 arXiv v2 增加 Juncai Liu 与 Ru Zhang,并移除 Mu Qiao。团队主体由 ByteDance Seed 与清华大学智能产业研究院共同组成,SIA-Lab 连接两家机构,Guangming Sheng 同时连接香港大学。
论文脉络
1. 研究问题、背景和价值
DAPO 研究如何在 32B 基础模型上稳定扩展可验证奖励强化学习(reinforcement learning with verifiable rewards, RLVR),使模型仅通过规则化正确性奖励学习数学长思维链。研究对象包含算法目标、采样策略、长度处理和分布式训练系统。论文将训练过程中的四类现象作为直接问题:低概率正确 token 的更新受对称裁剪限制、全对或全错的 prompt 组不产生组内相对优势、按样本平均的损失改变不同长度回答的 token 权重,以及长度上限造成截断回答和奖励噪声。
该工作的价值来自完整公开的训练对象。DeepSeek-R1-Zero 已表明纯强化学习可以形成推理行为,其训练数据、完整超参数和中间训练动态未公开。DAPO 同时发布 DAPO-Math-17K、训练代码、模型、日志和基础设施配置,使 32B 长思维链强化学习具备可检查的实现路径。
2. 已有解决方案与不足
朴素基线采用 GRPO:每个 prompt 采样一组回答,用组内奖励均值和标准差构造相对优势,再对每条回答的 token 损失取平均。论文观察到以下限制:
- PPO/GRPO 的对称裁剪对概率接近零的 token 给出很小的绝对增长余量,正优势 token 的探索可能过早受限。
- 在仅使用二元正确性奖励的基线中,同一组回答全部正确或全部错误时,组内奖励方差为零,归一化优势不提供有效训练信号;这些组仍占用 rollout 与训练批次。
- 样本级平均先令每条回答权重相等,因此长回答中单个 token 的权重低于短回答中的 token。
- 直接把超过生成上限的回答判错会在长度边界产生不连续惩罚,训练可能优先改变回答长度。
- 参考策略 KL 正则会限制策略偏离,论文的目标设置强调从基础模型直接探索,因此 DAPO 目标移除 KL 项。
这些问题覆盖算法和系统边界。动态采样改变实际进入更新的 prompt 分布,并增加候选 rollout;超长处理依赖生成上限和解码系统;token 级聚合对长度分布敏感。方法名称无法单独确定可复现实验对象,具体配置需要同时给出数据、批次、采样、奖励、损失聚合和代码版本。
3. 作者可能的思考路径
以下为本地分析。若从朴素 GRPO 的无效更新开始诊断,首先可以按组内正确性差异将 batch 分成有效组与退化组;移除退化组并持续补采后,每轮更新保持固定的有效 prompt 数量,但 rollout 数量成为随机变量。随后检查有效组中的概率变化,会发现对称上界对低概率正优势 token 的绝对增长限制较强,于是将正优势方向的上界单独放宽。再检查不同回答长度对目标函数的贡献,可以把“每条回答等权”改为“组内全部 token 等权”。最后,长度上限仍会把接近边界的生成转化为突变奖励,因此在上限前加入连续惩罚区间。
这条重建路径与论文四项技术的作用顺序一致,也解释了它们的接口关系:动态采样决定哪些组传给优化器,奖励整形决定每条回答的标量奖励,解耦裁剪决定单 token 概率比的可接受变化,token 级聚合决定这些单 token 项如何合成一次更新。论文未给出该构思过程的历史记录,因此本段不作为作者动机的直接证据。
4. 核心假设或切入点
DAPO 依赖三个核心判断。第一,可执行的答案等价性规则足以提供低噪声的结果奖励,过程监督可以省略。第二,组内至少同时存在正确和错误回答时,相对优势才携带区分信号,训练可以通过额外 rollout 补齐固定数量的有效 prompt 组。第三,长思维链训练中的长度、熵和采样效率问题可以通过局部目标与数据流调整缓解,无需引入价值模型。
这些判断要求任务具有可靠的答案验证器、每个 prompt 可以并行采样多条回答、系统具有额外 rollout 余量,并且回答长度上限可由训练框架一致执行。代码生成、开放式问答或验证器覆盖不足的任务不满足第一项条件;极难或极易的数据会提高动态采样的额外生成成本。
5. 贡献全景与方法总览
首要贡献是一条端到端的开放强化学习训练流程。辅助贡献包括 DAPO-Math-17K、基于 verl 的分布式实现、训练日志和模型权重。四项算法技术分别作用于概率更新、prompt 组选择、损失聚合和长度奖励,最终共同产生更新当前策略的标量目标。
DAPO 在文中具有四个相关含义:DAPO 算法指解耦裁剪、动态采样、token 级聚合与超长奖励整形组成的目标;DAPO 训练配方还包括数据、规则奖励、无 KL 配置与超参数;DAPO 系统指 verl 上的生成、过滤和训练数据流;DAPO-Qwen-32B 指该流程训练得到的模型。后文分别使用这些名称。
策略对象也需要区分。当前策略
从计算图看,四项技术修改的是四个不同算子。超长奖励整形修改回答级奖励;动态采样修改进入期望的轨迹组分布;Clip-Higher 修改每个 token 的代理目标;token 级损失修改这些代理项的归约方式。参考策略 KL 的移除发生在目标定义层,整数答案转换发生在奖励环境层。这个分解说明了各项机制的接口:奖励与过滤在优势计算前生效,裁剪在优势确定后生效,token 级归约最后决定不同长度轨迹的相对权重。
| 阶段 | 输入 | 核心操作 | 传递对象 | 输出及作用 |
|---|---|---|---|---|
| 1. 数据与验证 | 数学 prompt、标准答案 | 清洗 DAPO-Math-17K,并配置答案等价性规则 | prompt、答案、验证器 | 可执行的正确性奖励环境 |
| 2. 组式 rollout | 旧策略快照、prompt | 每个 prompt 采样 16 条回答,并执行 16,384 token 目标长度与 4,096 token 缓冲区 | 回答、token 概率、长度 | 候选轨迹组 |
| 3. 奖励构造 | 回答、标准答案、长度 | 计算正确性奖励与超长软惩罚 | 每条回答的总奖励及正确性指标 | 优势计算与长度控制信号 |
| 4. 动态采样 | 候选轨迹组 | 移除全对或全错的组,继续生成直至有效 prompt 数达到训练批次 | 策略依赖的有效轨迹组 | 固定有效 prompt 数并改变实际训练分布 |
| 5. 相对优势与解耦裁剪 | 有效组、回答总奖励、旧策略概率 | 组内标准化奖励;分别设置正、负优势方向的平台边界 | 每个 token 的裁剪代理项 | 放宽低概率正优势 token 的增长范围 |
| 6. token 级聚合与更新 | 全部 token 代理项 | 按 token 总数归一化,执行 |
新的当前策略参数 | 按长度重分配序列权重,并输出 DAPO-Qwen-32B 与训练 checkpoint |
论文主设置以 512 个有效 prompt 为 rollout 训练批次,每个 prompt 采样 16 条回答,AdamW 学习率为
6. 数据、规则奖励与无 KL 起点
输入是从网页与竞赛材料整理的数学问题及标准答案。作者通过抓取和人工标注构建 DAPO-Math-17K,并把非整数答案转换为整数形式以简化验证。论文主文未披露完整来源清单;OpenReview 回复将来源补充为 Art of Problem Solving 等网站,并声明对评测集执行去污染。数据传给 rollout 阶段的对象包含 prompt、标准答案和答案等价性验证器。
Appendix B 给出的具体例子说明该转换会修改问题及目标。原题最小值为
验证器将正确答案记为
参考策略
这一阶段的输出是可执行奖励环境。边界来自验证器质量和数据覆盖:答案形式转换可能缩小任务分布,规则无法检查推理过程,正确答案也可能由无效中间推理得到。无 KL 配置的主文没有同设置消融;作者回复报告 Qwen2.5-Math-7B 在 3,000 step 时无 KL 与有 KL 的 AIME avg@32 分别为 28 和 26,该结果未进入 camera-ready 正文。
7. 组式 rollout、长度缓冲区与超长奖励整形
旧策略快照对每个 prompt 并行采样 16 条回答。论文将目标回答长度设为 16,384 token,并增加 4,096 token 的软惩罚缓冲区,因此生成上限为 20,480 token。轨迹携带回答 token、旧策略概率、验证结果和长度,传给奖励构造与动态采样阶段。
长度整形解决接近上限时的奖励突变。令
这一加法保留了正确性排序。令
在论文惩罚系数为 1 的设置中,正确回答的总奖励位于
长度整形还会进入组内标准化。以两条正确、两条错误回答为例,未触及缓冲区时奖励为
论文还讨论超长过滤(Overlong Filtering):截断回答仍保留 rollout,但对应 token 不进入策略损失。Figure 5 直接比较的是超长过滤,图注将其统称为 Overlong Reward Shaping。当前官方 DAPO 复现代码未启用该机制,README 说明最佳运行大多仅使用超长奖励整形,因为两者作用重叠。Table 1 中逐行加入技术的开发轨迹因此不代表最终配置严格累积包含前面所有行。直接证据位于 Section 3.4、Equation 13、Figure 5,以及 verl-recipe/dapo/README.md 的 FAQ。
8. 动态采样构造有效训练批次
动态采样接收候选轨迹组,并用组内正确性指标的标准差判定有效性。设一组包含
条件要求组内同时存在正确和错误回答。以
原文用约束式表示过滤,实际数据流等价于按当前策略进行拒绝采样。以下为基于 Equation 11 的独立推导。令单条回答对问题
持续生成直至获得足量有效组后,进入优化器的 prompt 分布近似为:
这个分布随策略更新。它提高单次正确率处于中间区间的 prompt 权重,并降低单次正确率接近 0 或 1 的 prompt 权重。对于论文的
| 单条回答正确率 |
接受率 |
每个有效组的期望候选组数 |
|---|---|---|
| 0.01 | 0.148542 | 6.732 |
| 0.10 | 0.814698 | 1.227 |
| 0.50 | 0.999969 | 1.000 |
| 0.90 | 0.814698 | 1.227 |
| 0.99 | 0.148542 | 6.732 |
因此,动态采样同时完成两个动作:移除按正确性定义的退化组,并实施策略依赖的难度重加权。论文只直接主张前一项;后一项由过滤条件推出,论文没有测量 max_num_gen_batches 和最终截取前 512 个有效组都会使实际分布偏离上述理想形式。
Algorithm 1 第 6 行写成过滤单个 train_batch_size,因此 buffer 的顺序与生成批次边界属于复现状态的一部分。
该阶段把有效轨迹组传给优势计算,保证每个进入更新的 prompt 都有按正确性定义的组内区分信号,并维持固定的有效 prompt 数量。它没有固定优势幅值、token 数、clip fraction 或梯度方向之间的相关性,因此“有效组数量固定”不能直接推出梯度方差降低。代价包括额外 rollout、实际 prompt 分布的策略依赖变化,以及过滤条件对验证器输出的依赖。论文对系统效率的解释假设同步、无流水线训练,长尾序列会使其他设备等待;在异步或充分流水线化系统中,该等待模型需要重新测量。直接证据位于 Section 3.2、Equation 11、Figure 3b、Figure 6、Algorithm 1 和当前 dapo_ray_trainer.py 的按 prompt UID 分组过滤实现。
9. 组内优势与 Clip-Higher
有效组的回答级总奖励首先在组内标准化。令
proceedings Equation 4 的分子写成小写
在长度项为零、奖励仅取
正确与错误回答分别获得:
该式揭示组相对优势的自适应缩放:
Clip-Higher 解决正优势 token 的上行裁剪限制。令单 token 代理项为
因此,
这一机制的最小例子是旧概率为 0.01 的正优势 token:对称裁剪上界 1.2 对应 0.012,概率的代理目标平台区只增加 0.002;旧概率为 0.9 时,同一比例给出形式上的 1.08,实际概率受 1 的上界约束。一般地,比例上界对应的形式增量为
直接证据位于 Section 3.1、Figure 2、Figure 3 与 Table 2。Table 2 在约 3,000 step 的单一设置下报告
10. token 级策略梯度聚合与参数更新
为说明聚合差异,令
DAPO 改为对组内全部 token 统一归一化:
样本级聚合令每条回答的总权重相等;token 级聚合令每个 token 的归一化系数相等,因此长回答在序列层面获得更高总权重。设
因此,长度高于组内平均值的回答中,每个 token 相对样本级 GRPO 被提高权重;长度低于平均值的回答被降低权重。若两条回答长度分别为 100 和 900,样本级聚合给两条回答各
这一变化还会使长度与优势发生显式耦合。组内标准化保证回答级优势均值为零:
token 级聚合对应的长度加权优势均值为:
它仅在长度与优势的组内加权关系恰好抵消时为零。以一条长度 900、优势
DAPO 的完整代理目标可写为:
其中期望仅覆盖动态采样保留的有效组。组内奖励决定优势方向,概率比与解耦裁剪限制单 token 更新,token 总数归一化决定不同长度回答的相对权重。优化器据此更新当前策略,并在下一轮形成新的旧策略快照。
该方法仍把回答级结果优势复制到全部 token,因此没有解决轨迹内部的精细信用分配。长度分布变化会直接改变序列总权重,跨设备实现还需要明确聚合范围。论文 Equation 12 以单个 prompt 组的总 token 数作分母,当前复现配置以 loss_agg_mode=token-mean 实现批次归约;数据并行重平衡和 mini-batch 切分会决定工程实现中的实际归一化范围。直接证据位于 Section 3.3、Equation 12、Figure 4 和 Algorithm 1。
11. 机制耦合与训练诊断
以下关系一部分由原文直接陈述,一部分由前述公式独立推出;论文没有提供四项机制的完整因子实验。
- 无 KL 与 PPO 裁剪形成不同时间尺度的约束。 Section 2.3 移除固定参考策略的长期参照,Algorithm 1 仍在每个外层 step 固定旧策略并执行
次裁剪更新。单轮代理目标具有局部平台区,外层刷新旧策略后该局部参照随之移动。因此,DAPO 允许跨 step 累计偏移,同时控制单轮更新的代理目标。 - Clip-Higher 与动态采样通过回答多样性发生间接耦合。 原文 Figure 2 报告 Clip-Higher 提高生成熵,Figure 3b 显示全对 prompt 比例随训练增加。若更高熵提高同一 prompt 内正确与错误结果共存的概率,它会提高
并降低动态补采成本;熵也可能来自与正确性无关的文本变化,因此该关系属于解释性假说。验证需要联合记录组内答案重复率、正确性接受率、clip fraction 与额外生成 batch 数。 - token 级聚合与超长奖励产生长度相关的联合效应。 token 级聚合把长回答的序列总权重提高到
;进入 4,096 token 缓冲区后,长度奖励又随长度线性下降,并通过组内标准化改变优势。较长的高奖励轨迹与较长的低奖励轨迹会分别放大正向和负向系数。Figure 4 提供 token 级聚合曲线,Figure 5 比较超长过滤,Table 1 记录加入超长软惩罚后的开发结果;这些证据没有构成两项机制的联合消融,也未报告长度—正确性分层结果。 - 训练奖励、验证准确率、长度和熵承担不同诊断功能。 Section 4.3 与 Appendix A 报告训练奖励通常稳定上升,但最终训练奖励与验证准确率相关性较弱;作者同时跟踪回答长度、生成熵和平均 token 概率。训练奖励只能确认策略在拟合当前奖励环境,验证准确率用于检查外部任务表现,长度和熵用于定位截断、重复生成与探索状态。单个监控量不足以判定训练质量。
12. 结论链条
- 假设:数学答案验证器能够提供可靠结果奖励,并且每个 prompt 可采样多条回答。
- 机制:动态采样以拒绝采样形成策略依赖的有效 prompt 分布;超长整形在保持正确性排序的条件下加入长度偏好;Clip-Higher 分别控制正、负优势方向的平台边界;token 级聚合按回答长度重分配序列总权重。
- 直接证据:Table 1 的开发轨迹把 AIME 2024 avg@32 从朴素 GRPO 的 30 提高到完整 DAPO 的 50;Table 2、Figures 2–6 分别提供裁剪上界、生成熵、被上裁剪 token 概率、全对 prompt 比例、响应长度、超长过滤和动态采样训练曲线;官方复现包报告完整配置 52、移除动态采样 50。
- 最窄结论:在 Qwen2.5-32B Base、DAPO-Math-17K、规则奖励和论文级系统配置下,这组联合设计能稳定训练出 AIME avg@32 约 50 的模型,并达到公开复现。
- 边界:主文缺少多随机种子、同算力强基线和多任务主实验;逐阶段表格与当前最终代码存在配置差异;动态采样后的 prompt 分布、长度与优势的相关性及四项技术的交互效应均未直接测量;各技术的独立因果贡献不能由 Table 1 直接相加。
关键实验/定理
结果 1:主训练曲线与最终 AIME 结果
- 设置:Qwen2.5-32B Base;DAPO-Math-17K;每个 prompt 采样 16 条回答;最长生成 20,480 token;AIME 2024 以温度 1.0、top-p 0.7 重复 32 次。
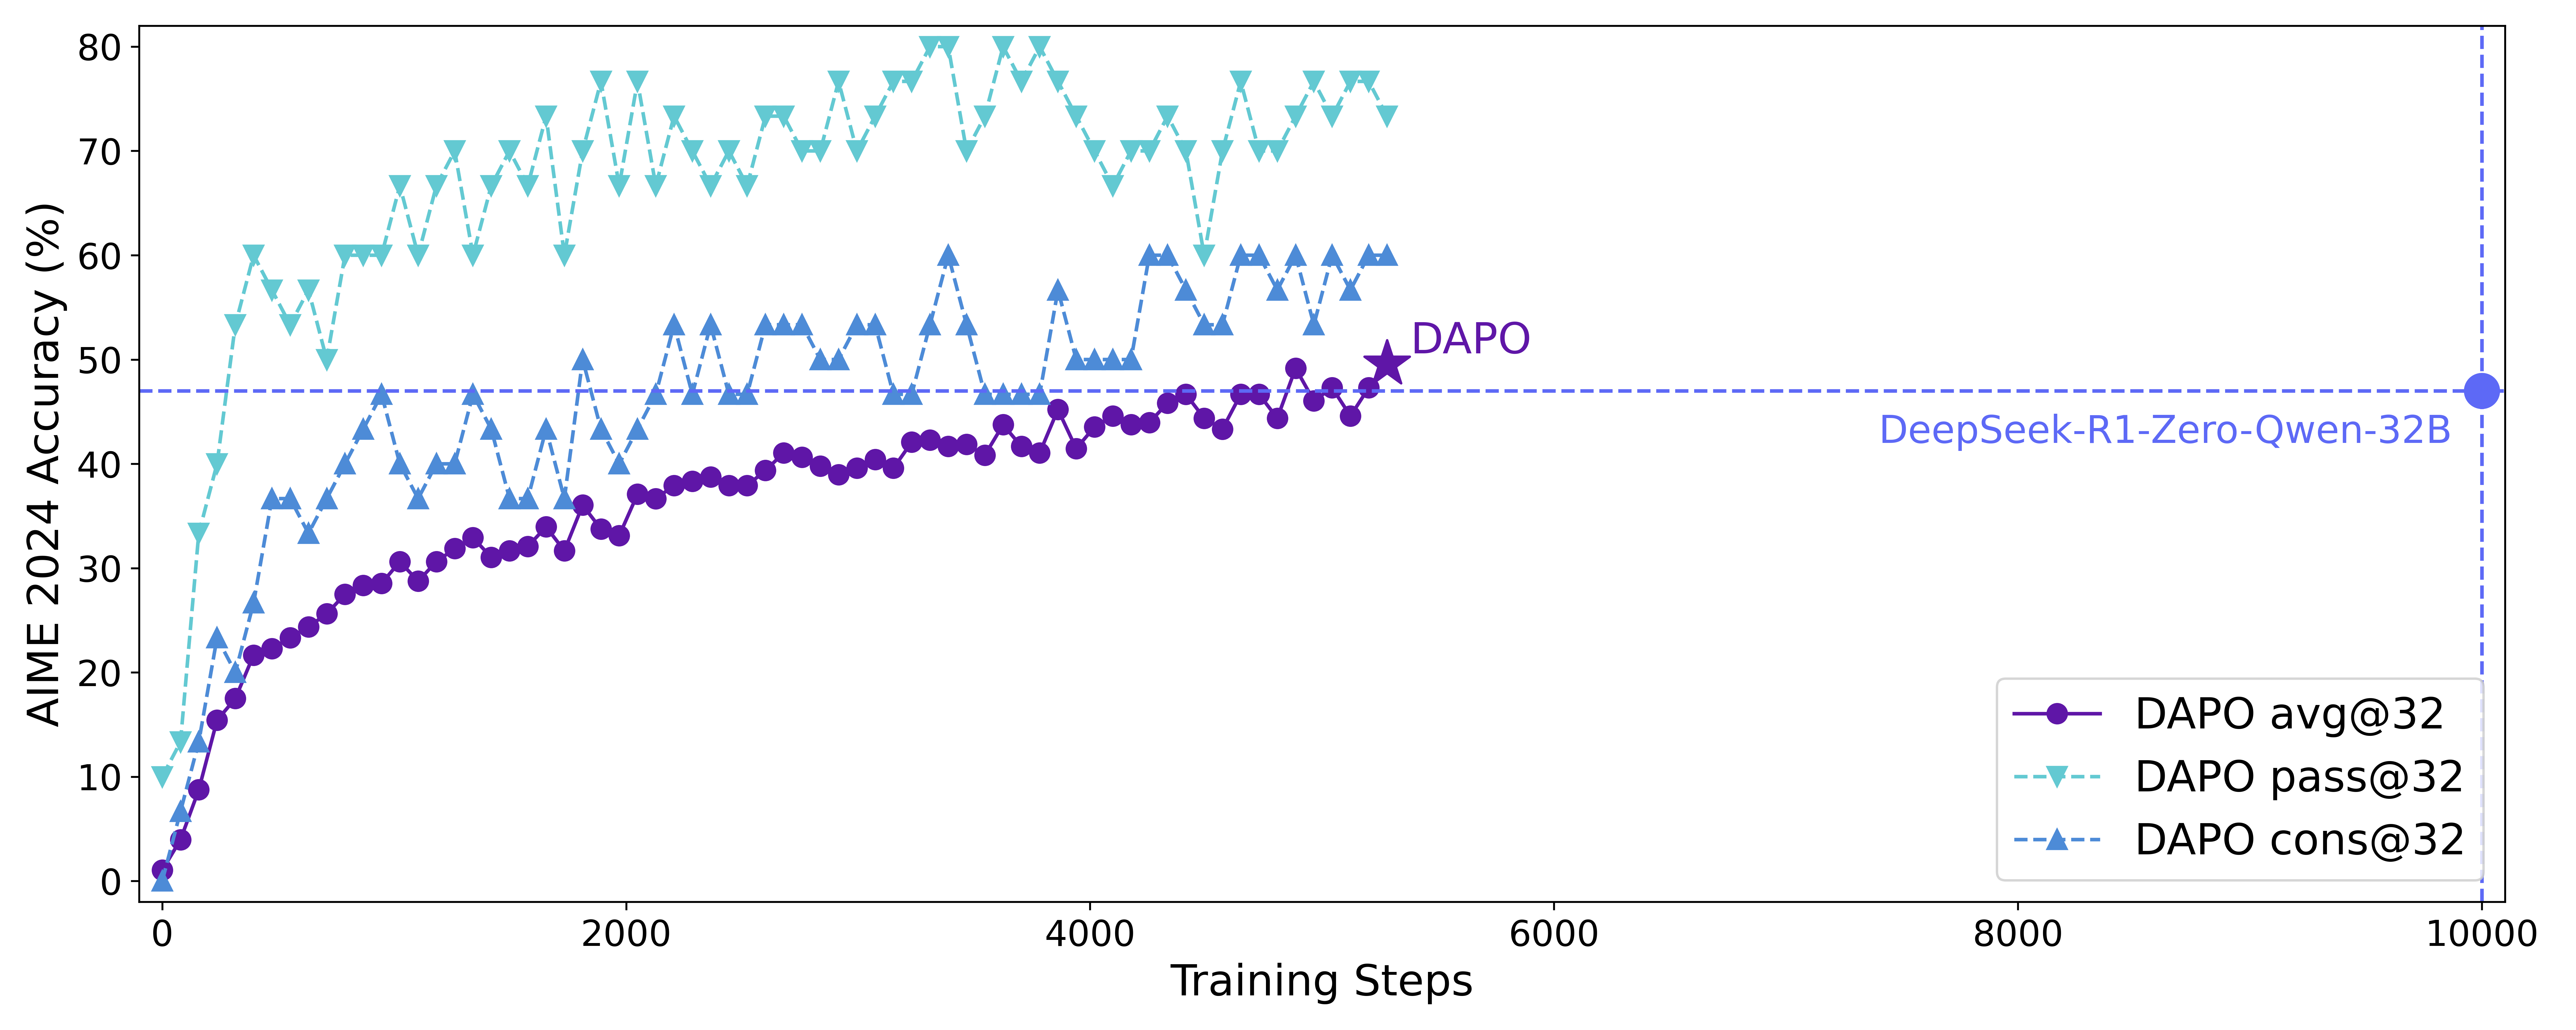
- Baseline:朴素 GRPO 得分 30;论文引用的 DeepSeek-R1-Zero-Qwen-32B 得分 47。
- 指标:AIME 2024 avg@32,表示 32 次独立评测的平均准确率。
- 结果:完整 DAPO 得分 50;Figure 1 报告达到该水平所需梯度 step 约为 DeepSeek-R1-Zero-Qwen-32B 的一半。
- 证据定位:NeurIPS proceedings Section 1、Table 1、Figure 1;arXiv v2 Figure 1。
- 支持的最窄结论:论文配置在该模型和基准上显著高于作者实现的朴素 GRPO,并达到 50 avg@32。
- 对照是否可比:朴素 GRPO 与 DAPO 共享作者训练环境,适合比较联合配方;DeepSeek-R1 的数据、批次和完整训练配置未公开,step 效率仅作参考。
- 系统条件:论文报告训练使用 128 张 H100 GPU;OpenReview 回复补充完整训练约一周。
- 指标定义:avg@32 对 32 次随机采样结果取平均,未报告置信区间。
- 成本归因:算力数字来自审稿回复,正文未分解 rollout、过滤和优化成本。
- 解读:最可靠证据支持 DAPO 联合配置的可训练性和结果水平,无法从主曲线分离四项技术的独立贡献。
结果 2:Clip-Higher 的上界消融
- 设置:Qwen2.5-32B Base,训练约 3,000 step;固定
,改变 。 - Baseline:对称裁剪
。 - 指标:AIME 2024 avg@32;策略熵与 clip fraction 作为训练诊断。
- 结果:
为 0.20、0.25、0.28、0.30、0.40 时,avg@32 分别为 28.4、30.3、41.8、40.3、37.2;论文选择 0.28。 - 证据定位:Section 3.1、Table 2、Figures 2–3。
- 支持的最窄结论:在该单一训练设置中,0.28 优于对称裁剪和其余测试上界,并伴随更高策略熵。
- 对照是否可比:表内共享模型与主要配置;正文未报告随机种子重复和误差区间。
- 系统条件:结果在完整分布式训练流程中测得,单次运行成本未单列。
- 指标定义:clip fraction 记录概率比落出受保护区间的 token 比例。
- 成本归因:裁剪本身不增加 rollout;性能差异可能同时经过后续采样分布变化累积。
- 解读:消融支持解耦上界这一局部设计,0.28 的跨模型稳定性仍待验证。
结果 3:长度处理与 token 级聚合的开发轨迹
- 设置:Table 1 依次列出朴素 GRPO、超长过滤、Clip-Higher、超长软惩罚、token 级策略梯度损失和动态采样。
- Baseline:朴素 GRPO 的 AIME 2024 avg@32 为 30。
- 指标:AIME 2024 avg@32;Figure 4 报告生成熵和平均响应长度,Figure 5 报告超长过滤前后的 AIME avg@32 与生成熵。
- 结果:Table 1 各行依次为 30、36、38、41、42、50。
- 证据定位:Table 1、Sections 3.3–3.4、Equations 12–13、Figures 4–5;官方
verl-recipe/dapo/README.mdFAQ。 - 支持的最窄结论:长度处理、裁剪、聚合和采样逐步加入后,开发配置的最终结果达到 50。
- 对照是否可比:Table 1 是开发轨迹;官方 README 说明最佳运行多数未使用超长过滤,最终代码没有实现该项,因此各行不能解释为严格累积且仅改变一个变量的独立消融。
- 系统条件:最大生成长度与软缓冲区共同决定可达长度范围。
- 指标定义:平均响应长度按生成 token 数计算;生成熵来自 actor 的 token 概率分布;AIME avg@32 为 32 次评测准确率的平均值。
- 成本归因:长度上限影响生成成本;token 级聚合主要改变目标权重,未增加 rollout。
- 解读:该表支持联合开发过程,单项增益需要额外受控消融确认。
结果 4:动态采样的论文结果与当前官方复现
- 设置:论文记录全对 prompt 比例,并比较启用与移除动态采样的训练曲线;当前官方复现包在同一硬件级配置下比较完整 DAPO 与移除动态采样。
- Baseline:
DAPO w/o Dynamic Sampling。 - 指标:AIME 2024 avg@32;有效 prompt 数;额外生成 batch 数。
- 结果:当前官方复现表中完整 DAPO 为 52,移除动态采样为 50;论文 Table 1 的开发轨迹在加入动态采样前后为 42 和 50。
- 证据定位:Section 3.2、Equation 11、Figure 3b、Figure 6、Algorithm 1、Table 1;
verl-recipeDAPO README at commit52cdedf;paper reproduction coreverlcommit4f80e465c2ec79ab9c3c30ec74b9745de61d0490。 - 支持的最窄结论:动态采样保证固定数量的有效 prompt 进入更新;当前官方受控复现中的 avg@32 差值为 2。
- 对照是否可比:当前复现表的两项共享硬件和 core commit,比较范围较清晰;README 未给出多随机种子结果。论文 Table 1 的 8 分差值包含开发阶段配置变化,证据强度较低。
- 系统条件:完整复现使用 16 个节点、每节点 8 张 H800;训练脚本以 1,536 个候选 prompt 生成并补齐 512 个有效 prompt,最多生成 10 个 batch。
- 指标定义:过滤条件为同一 prompt 的正确性指标标准差大于零。
- 成本归因:有效 batch 更稳定,同时增加候选 rollout;论文没有报告过滤率分层下的 GPU 时间。
- 解读:动态采样的直接保证是有效训练信号数量;精度收益与额外生成成本需要共同报告。
结果 5:开放复现对象及版本边界
- 设置:检查论文项目、当前
verl-recipeDAPO 目录、核心verl版本、公开数据与模型。 - Baseline:DeepSeek-R1-Zero-Qwen-32B 未公开等量训练配方。
- 指标:训练对象是否具备代码、数据、模型、超参数和版本指针。
- 结果:DAPO 发布 DAPO-Math-17K、DAPO-Qwen-32B、训练脚本与日志;当前复现目录将论文运行固定到 core
verlcommit4f80e465...。 - 证据定位:论文 Abstract、Section 4、Appendix B;
verl-recipe/dapo;REQUIRED_VERL.txt;DAPO wrapper repository。 - 支持的最窄结论:公开材料足以确定核心训练数据流和论文复现所需的
verl版本。 - 对照是否可比:该结果属于材料完整度评估,不涉及模型精度比较。
- 系统条件:官方 README 给出 H100、H800 与 H20 配置;硬件和
verl版本会影响吞吐与内存行为。 - 指标定义:版本指针要求仓库 commit 与核心依赖 commit 同时固定。
- 成本归因:OpenReview 回复报告 128 张 H100 训练约一周;公开仓库没有完整成本账单。
- 解读:复现时应采用
verl-recipe当前 DAPO 目录及其固定 core commit;旧 DAPO README 中指向volcengine/verl开发分支的链接已失效。
OpenReview / 审稿意见吸收
- Reviewer consensus: 4 份公开评审普遍认可开源代码、数据、模型和训练细节的实践价值,也认可论文结构清晰及 AIME 结果具有竞争力。最终分数分布为 2 至 5,置信度为 3 至 5;最终决定为 NeurIPS 2025 poster 接收。OpenReview API 在 2026-08-04 以认证状态读取到 22 条可见 note,覆盖 submission、review、rebuttal、comment、decision 与 acknowledgement。
- Main criticisms: 主要意见集中于单项技术新颖性有限、主文仅使用一个模型与一个主要基准、朴素 GRPO 基线偏弱、与 DeepSeek-R1 的比较配置不透明、缺少多随机种子和置信区间、算力成本及 KL 消融最初未披露。动态采样的效率回复表格还把 baseline 与 dynamic sampling 的耗时列对调,作者后续评论确认该错误。
- Author response: 作者补充 Qwen2.5-32B 上六项评测,DAPO 与 GRPO 分别为 AIME 52/30、MATH500 81/62、AMC 88/72、Minerva 34/17、Olympiad 51/34、LiveCodeBench 62/50;另补充 Qwen2.5-7B、Qwen2.5-Math-7B 和总参数 200B、激活参数 20B 的内部 MoE 结果。回复还报告无 KL 与有 KL 在 Qwen2.5-Math-7B、3,000 step 时为 28/26,并说明完整训练使用 128 张 H100、约一周,每项技术只运行一次。上述数字来自 rebuttal,未收录于 camera-ready 正文,部分训练配置未完整披露。
- 对可信度的影响: OpenReview 补充扩大了任务与模型覆盖,并确认算力和数据来源;单次运行、基线强度、配置披露和表格错误仍限制精确效应量判断。接收决定将论文定位为实用、可复现的系统与训练配方贡献,同时保留对新颖性和实验广度的限定。
主要启发
1. 训练配方需要用版本化数据流定义
DAPO Table 1、Section 3 的 camera-ready 公式与当前官方 verl-recipe 代码对应三个不同层级:开发轨迹记录技术加入顺序,论文定义最终算法,仓库固定可执行配置。官方 README 进一步说明超长过滤未进入多数最佳运行,当前脚本的 warm-up 和生成批次也与论文设置不同。这些证据共同表明,复现实验对象需要同时记录数据版本、rollout 批次、过滤条件、奖励组合、损失聚合、仓库 commit 和核心依赖 commit。
该判断可迁移到其他强化学习训练系统:先把论文定义、开发消融和公开可执行配置分别版本化,再检查三者的数据流差异。若三层对象由同一不可变配置生成且输出摘要一致,所需版本信息可以缩减;任一层改变 rollout 采样、过滤位置或损失归约时,应继续保存独立标识。
2. 动态采样通过额外 rollout 保持固定的有效更新批次
论文 Section 3.2 的 Equation 11、Algorithm 1 与当前训练代码都表明,全对和全错组被移除,系统继续生成直到有效 prompt 数达到目标。独立推导得到接受率
迁移这一设计时应同时测量按难度分层的接受率、候选 rollout 数、有效 batch 大小、墙钟时间和训练分布变化。若动态采样提高有效更新信号且单位 GPU·小时收益同步改善,迁移预测成立;异步生成、流水线训练或极端难度数据使补采样成本超过精度收益时,该判断失效。
3. token 级聚合调整长度权重并保留结果级信用分配
Section 3.3 的 Equation 12–13 显示,token 级聚合令回答
迁移到其它长轨迹强化学习时,应先按长度、正确性、截断状态和优势符号统计梯度贡献。若 token 级聚合的收益主要出现在长且正优势的轨迹,长度重加权解释得到支持;长度匹配后差异仍然存在时,需要检查 mini-batch 归约、mask 或过程级梯度等替代机制。
局限
- 主文核心结果集中于 Qwen2.5-32B Base 与 AIME 2024,OpenReview 补充实验扩大覆盖范围,但未提供与主设置等量的超参数、训练曲线和代码快照。
- Appendix D 将任务范围限定为单轮强化学习和具有数值答案的数学问题;多轮交互与证明题缺少验证,规则奖励和整数答案转换也无法直接迁移到这些场景。
- Table 1 是逐阶段开发轨迹,超长过滤与最终最佳配置存在差异;四项技术的独立贡献和交互效应尚无完整因子消融。
- 论文和回复均说明每项技术只运行一次,未报告随机种子方差、置信区间或统计显著性。
- Appendix C 只用个案展示反思与回溯文本,没有统计训练前后出现频率、正确性贡献或替代解释,无法单独确认新的推理能力形成。
- 动态采样把原始数据分布变为策略依赖的接受分布,额外 rollout 成本依赖题目难度和系统流水线;论文没有报告接受分布、按难度分层的过滤率或序列长度分解后的 GPU 时间。
- token 级聚合仍使用回答级优势,无法定位轨迹内部的局部错误,并会把长度与优势方向联系起来;论文未披露长度—正确性联合分层的梯度统计。
- DeepSeek-R1-Zero-Qwen-32B 的训练数据、批次和完整系统配置未公开,50% 梯度 step 优势不具备严格同条件可比性。
- DAPO-Math-17K 的抓取、人工标注、整数化转换和去污染细节未完整公开;整数化会增加答案形式信息并改变预测目标,转换前后的问题难度与数据覆盖需要独立审计。
- 论文公式没有明确
std的自由度约定及 token 归约跨 mini-batch、数据并行设备的范围;这些实现选择会改变优势尺度和长度权重。 - Algorithm 1 第 6 行把动态采样写成单回答过滤,Equation 11 与官方代码执行整组过滤;当前官方代码目录、旧 wrapper 仓库和论文配置也存在版本差异,复现结论需要绑定
verl-recipe与 coreverl的双重 commit。 - Tricks or Traps / Lite PPO 在 Qwen3 4B/8B Base 与对齐后检查点上重新检查 DAPO 组件,观察到 token 级聚合、Clip-Higher 和超长过滤的收益随初始化、奖励方差、裁剪触发率和生成上限变化。该证据限定 DAPO 配方的外部有效性;其实验与 DAPO 原始 Qwen2.5-32B、16 条 rollout、约 20K 长度和 AIME 设置不同,arXiv v3 主体为单随机种子,审稿补充也只在一个 Qwen3-8B Base Hard 设置中提供三随机种子,因而不构成同条件反证。
跨论文关系
- 与已有论文的作者或机构关系:DAPO 与 HybridFlow 共享 ByteDance/
verl基础设施脉络,Haibin Lin、Guangming Sheng、Yuxuan Tong、Chi Zhang 和 Wang Zhang 等作者形成直接重叠。 - 与已有论文的主题关系:DeepSeek-R1 提供纯强化学习推理能力的主要参照,DAPO 补充开放数据、代码和训练动态;RLVR 推理边界研究 区分 pass@1 改善与 pass@k 能力边界,限制了仅凭 avg@32 推断基础能力扩展的范围。
- 与已有论文的方法关系:ProRL 延续解耦裁剪与动态采样,并为长期训练重新引入 KL 与参考策略重置;MiniMax-M1 以 DAPO 为长上下文强化学习基线,并用 CISPO 调整裁剪方式;熵机制分析 从训练动态解释策略熵变化与 Clip-Higher 的作用边界;训练—推理不一致研究 进一步检查长回答下 token 聚合与推理估计的一致性;Tricks or Traps / Lite PPO 在 Qwen3 Base/对齐后与不同长度上限中重新测试这些组件,把其收益进一步限定到奖励标准差、裁剪触发率和响应长度分布。