阅读笔记
On the Design of Qwen3.8 Next Architecture: Evaluation, Efficiency, and Training Stability
Qwen3.8-Flash-Next 将三层 Gated DeltaNet 与一层 Qwen Sparse Attention 交错,并用四分支门控残差、可卸载的 N-gram Embedding 和重新拟合的 Muon 训练配方共同降低训练与长上下文推理成本;125B 主模型每个 token 激活约 6B 参数,在十四项预训练评测中有八项超过 397B-A17B 的 Qwen3.7-Plus-Base,同时使用约三分之一的训练 token 和约九分之一的训练 FLOPs,但报告没有披露完整数据账本、端到端服务测量或多随机种子复验。
所读版本 2026 08 28 访问的 GitHub main 分支版本;Hugging Face model card 与 config.json 作为模型配置和发布口径补充材料。
Source
- Workflow version: v2.1
- Material type: technical-report
- Analysis modules: experiment, system, model-report
- Canonical source: https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
- Title: On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability
- Authors: Qwen Team;Core Contributors: Zihan Qiu, Zekun Wang, Xiao Li, Yanpeng Li, Yang Xu, Yixuan Wang, Huaqing Zhang, Rui Men, Bo Zheng, Dayiheng Liu;Contributors: Bochao Mao, Chengruidong Zhang, Fan Zhou, Hao Luo, Haofeng Huang, Haoran Lian, Haoyan Huang, Hongqing Chen, Jianwei Zhang, Jing Xu, Junjie Wang, Langshi Chen, Liangyu Wang, Linlang Jiang, Man Yuan, Minmin Sun, Peng Jin, Siqi Zhang, Siyu Wang, Xingzhang Ren, Yakai Wang, Yi Zhang, Yiming Dong, Yizhong Cao, Yubo Ma, Yunfei Mao.
- Responsible organization: Qwen Team, Alibaba Group.
- PDF: https://github.com/QwenLM/Qwen3.8-Flash-Next/blob/main/tech_report.pdf
- Code/Project: https://github.com/QwenLM/Qwen3.8-Flash-Next;https://huggingface.co/Qwen/Qwen3.8-Flash-Next;https://qwen.ai/blog?id=qwen3.8-flash-next
- OpenReview / Review page: 按完整标题与模型名检索,未找到可可靠匹配的 OpenReview forum 或公开审稿内容。
- Published / updated: 2026-08-26.
- Current version read: 官方 GitHub PDF,报告日期 2026-08-26;未标注独立修订号。
- Version / revision read: 2026-08-28 访问的 GitHub
main分支版本;Hugging Face model card 与config.json作为模型配置和发布口径补充材料。 - Accessed: 2026-08-28
- Key figure decision: include
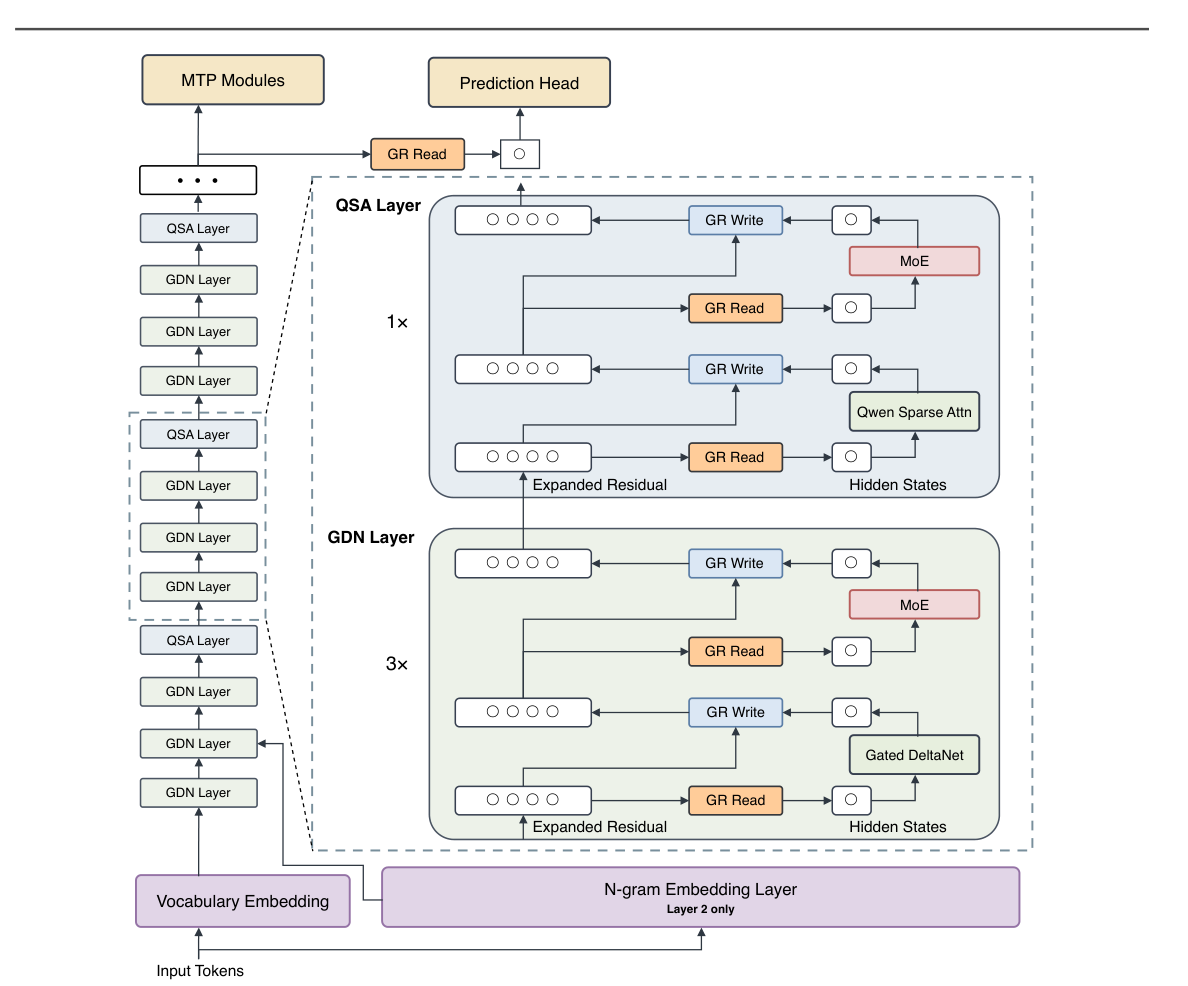
- Key figure rationale: Figure 1 在同一图中给出三层 GDN 与一层 QSA 的交错顺序、四分支 Gated Residual 的读写接口、第二层 N-gram Embedding 和 MTP 输出路径,是复述完整架构所需的关键接口图。
- Review status: page-type=not-found; match-confidence=high; observed-at=2026-08-28; venue-status=Alibaba Group technical report
- Subjects: large language models; mixture-of-experts; linear attention; sparse attention; training optimization.
作者与关系
- Core Contributors:Zihan Qiu、Zekun Wang、Xiao Li、Yanpeng Li、Yang Xu、Yixuan Wang、Huaqing Zhang、Rui Men、Bo Zheng 与 Dayiheng Liu;报告机构为 Qwen Team, Alibaba Group。Bo Zheng 与 Dayiheng Liu 为通讯作者。
- Contributors:Bochao Mao、Chengruidong Zhang、Fan Zhou、Hao Luo、Haofeng Huang、Haoran Lian、Haoyan Huang、Hongqing Chen、Jianwei Zhang、Jing Xu、Junjie Wang、Langshi Chen、Liangyu Wang、Linlang Jiang、Man Yuan、Minmin Sun、Peng Jin、Siqi Zhang、Siyu Wang、Xingzhang Ren、Yakai Wang、Yi Zhang、Yiming Dong、Yizhong Cao、Yubo Ma 与 Yunfei Mao;报告机构为 Qwen Team, Alibaba Group。
- 本地已有一位 MiniMax / Zhejiang University 的同名 Yang Xu;当前报告没有提供足够身份信息证明两者为同一人,因此本笔记保留姓名文本,不链接已有 profile。
Model Summary
| Field | Value |
|---|---|
| Architecture | 原生多模态稀疏 MoE;GDN + QSA 混合序列建模、Gated Residual、N-gram Embedding、MTP |
| Total Parameters | 主模型 125B;另有 51B N-gram Embedding 与约 4B MTP,语言侧发布口径合计约 180B |
| Activated Parameters | 每个 token 约 6B;该口径不把主机侧 N-gram 查表和 MTP 草稿步骤等同于主干激活参数 |
| Model Hidden Dimension | 2560 |
| Number of Layers | 48 |
| Number of Dense Layers | 0;语言主干每个 token-mixing 层后均接 MoE |
| Attention-Layer Composition | 12 ×〔3 个 GDN 层 + 1 个 QSA 层〕,共 36 个 GDN 层与 12 个 QSA 层 |
| GDN Dimensions | 16 个 Q/K heads、48 个 V heads;head dimension 128;短卷积宽度 4 |
| QSA Dimensions | 24 个 query heads、2 个 KV heads;head dimension 256;RoPE dimension 64 |
| QSA Indexer | 4 个 query heads、1 个共享 key head;head dimension 128;压缩比 4;预算 512 个微块或 2048 tokens |
| MoE Hidden Dimension (per Expert) | 640 |
| Number of Experts | 512 个路由专家 |
| Selected Experts per Token | 10 个路由专家 |
| Number of Shared Experts | 1 |
| Gated Residual | 4 个残差分支;低秩瓶颈 320,即模型隐藏维度的八分之一 |
| Vocabulary Size | 248,320(padding 后) |
| N-gram Embedding | 二元组与三元组;基础表规模 20,000,000;只在第 2 层加入 |
| Context Length | 原生 262,144 tokens;模型卡说明可用 RoPE scaling 扩展到 1,000,000 tokens |
| Attention Mechanism | Gated DeltaNet 固定大小循环状态 + QSA 微块级稀疏 softmax attention |
| Activation Function | SiLU / SwiGLU;GDN 和残差读写采用 sigmoid 门控 |
| Vision Encoder | 27 层,hidden size 1152,16 heads,intermediate size 4304,patch size 16,输出维度 2560 |
| Parameters of Vision Encoder | 官方材料未单列披露 |
| Quantization | 主配置为 BF16;报告说明残差状态可用 FP8 保存,模型发布另提供 FP8 权重;权重、激活值和量化感知训练的完整口径未披露 |
| Modality | 文本、图像、视频输入,文本输出 |
| License | Qwen Community License 1.0;商业 MaaS 和面向编码或办公的 AI 工作助手适用额外授权条款 |
参数口径需要分开阅读。125B 表示稀疏 MoE 主模型的总参数,6B 表示每个 token 的主干激活参数;51B N-gram 表通过稀疏查找增加容量,约 4B MTP 用于生成草稿 token。按 BF16 每参数两字节进行本地估算,约 180B 的语言侧权重需要约 360 GB 原始存储,其中 51B N-gram 表约占 102 GB。该估算不包含运行时状态、视觉编码器未单列的参数和框架额外开销。
论文脉络
1. 研究问题、背景和价值
报告把设计目标收缩为一个可检查的问题:能否让每个 token 只激活约 6B 参数的 125B 稀疏 MoE,在明显更少的训练 token 和训练 FLOPs 下保留上一代 397B-A17B 旗舰基座模型的能力,同时降低长上下文 prefill、decode 和训练不稳定带来的系统成本。这个目标要求同时处理 token 时间轴上的历史保存、网络深度方向的信息传递、稀疏专家的容量分配、主机与加速器之间的参数存放,以及新架构对应的最优批大小和学习率。
该问题的价值来自三类成本不会由同一个参数指标完整表示。总参数决定权重容量与存储,激活参数近似决定每 token 的矩阵计算量,注意力与循环状态决定长上下文的缓存和检索成本。Qwen3.8-Flash-Next 因此把能力、训练成本、prefill、decode 和训练稳定性并列为架构验收条件。
2. 已有解决方案与不足
完整自注意力为每个查询提供对全部历史 token 的直接访问,计算量随序列长度平方增长,KV Cache 则在自回归生成时线性增长。滑动窗口注意力减少计算与缓存,但窗口外信息需要经过多层间接传播。Gated DeltaNet(GDN)等线性注意力把历史压缩为固定大小状态,能够以线性成本持续更新,但有限状态无法精确保留任意 token 级关联。已有稀疏注意力用轻量索引器选择重要 token;上下文继续增长时,token 级索引器本身也会形成显著的二次计算。
网络深度方向也存在独立问题。传统 PreNorm 让所有子层读写同一残差流,早期特征会与后续写入共同占用同一通道。Hyper-Connections、mHC 和 Attention Residuals 等方法增加残差分支或跨层读取能力,同时引入额外状态访问、分支混合或约束成本。MoE 可以在固定激活参数下扩大专家容量,但全部容量仍需参与训练和权重存放;局部模式查表提供另一类参数扩展方式,其实际价值取决于下游能力、主机内存带宽和预取是否能够与主干计算重叠。
3. 作者可能的思考路径
以下为本地分析。若目标是把 Qwen3.7-Plus 的能力压缩到更低激活成本,单独扩大专家池会继续增加权重存储和通信,单独改用线性注意力会削弱精确检索,单独稀疏完整注意力仍会保留索引器成本。更可行的入口是按资源类型拆分机制:大部分层用固定状态执行连续压缩,少量层保留精确检索;残差路径沿深度保留特定中间表示;局部高频模式交给可卸载查表;MoE 继续承担输入相关的非线性计算。
架构变化随后会改变梯度与激活的尺度,沿用上一代最优超参数会低估新的稳定区间。报告因此用中等规模消融筛选架构,再用学习率压力测试提前暴露大规模长训练中的 loss spike,最后重新拟合批大小和学习率标度律。这条路径也解释了报告为何保留多项后期失败结果:移除 RoPE 和稀疏读取残差分支在预训练指标中接近基线,后训练或生成阶段出现了可定位退化。
4. 核心假设或切入点
方法依赖四个相互连接的判断。第一,有限状态的 GDN 和周期性稀疏 softmax attention 可以分别承担连续压缩与精确检索。第二,残差流的额外宽度只有在读写规则能选择具体跨层路径时才会充分转化为下游能力,逐通道读门控比完整分支混合更符合成本约束。第三,N-gram 查表与 MoE 专家承担不同功能,前者适合增加低计算成本的局部模式记忆,后者保留动态非线性计算。第四,显式乘性门控和 Muon 扩大稳定训练区间后,批大小与学习率需要重新拟合,上一代训练配方不能作为固定条件。
这些判断的成立还依赖实现条件:QSA 索引器必须在长上下文中足够准确,主干必须经过稀疏模式适配;N-gram 表需要确定性地址和可隐藏的主机预取;四分支残差状态需要融合 kernel 与低精度存储控制内存流量;Muon 的正交化边界需要按真实线性映射拆分。
5. 贡献全景与方法总览
首要贡献是一套联合架构选择方法:每项候选改动同时接受 loss 与下游评测、训练与推理成本、最优超参数与稳定性三类检查。QSA、Gated Residual、N-gram Embedding 和 Muon 配方构成辅助贡献,并分别处理长上下文检索、跨层状态、低 FLOPs 容量和优化稳定性。完整链条如下:
- 输入 token 先进入 248,320 项词表嵌入;第 2 层根据二元组和三元组地址读取主机侧 N-gram 表,并把预取向量加入当前表示。
- 语言主干重复十二个四层块;每个块先运行三个 GDN 层,把 token 历史压缩到固定大小循环状态,再运行一个 QSA 层,从压缩微块索引中选择最多 2048 个历史 token 执行稀疏 softmax attention。
- 每个 GDN、QSA 和 MoE 子层通过四分支 Gated Residual 读取输入并写回输出;逐通道读门控选择当前子层需要的跨层表示,每分支写标量控制新输出进入哪些路径。
- 每层 MoE 从 512 个路由专家中选择 10 个,并始终使用 1 个共享专家;MoE 提供输入相关计算,N-gram 表提供确定性局部模式记忆,两种容量同时保留。
- 预训练阶段先使用完整注意力;256K 继续预训练先蒸馏 QSA 索引器,再让主干与索引器联合适应稀疏访问模式。MTP 在推测解码的多个预测步复用 QSA top-k 索引。
- Muon 更新具有二维线性映射语义的权重,AdamW 更新嵌入、输出头、MoE Router 和 GR 低秩参数;融合矩阵在正交化前按独立映射拆分。重新拟合的标度律给出更大的目标批大小和学习率,正式训练直接从目标批大小开始。
- 最终输出为 Qwen3.8-Flash-Next 基座与后训练 checkpoint;报告的核心验收使用基座模型十四项评测、QSA 长上下文检索、内核时延、超参数验证和稳定性压力测试。
6. GDN 连续压缩与 QSA 精确检索
GDN 需要解决的局部问题是:用固定大小状态保存可更新的键值关联,并让重复或相似键修正已有记忆。对每个 head,报告维护状态
QSA 要降低稀疏注意力索引器的成本。它先将每
对查询
正式配置使用压缩比
QSA 在 256K 继续预训练中分两阶段加入。第一阶段只训练索引器 1000 步,用完整注意力分布经块内最大池化得到教师分布并最小化 KL,约消耗 2B tokens。第二阶段让主干和索引器联合训练 8000 步,约消耗 200B tokens,使主干适应稀疏访问模式。蒸馏后直接应用稀疏掩码会降低 RULER,联合训练后恢复到完整注意力水平,因此“索引器找到重要块”和“主干适应被选择的信息”是两个独立条件。
QSA 核心 attention 在固定预算下近似为
正式配置固定
7. Gated Residual 构造深度方向的信息路径
Gated Residual(GR)要解决单一残差流中早期特征与后续写入竞争的问题。残差状态被扩展为
子层输出
逐通道读门控决定当前子层从每条残差路径读取哪些特征,写标量决定新输出进入哪些分支。GR 移除了 Hyper-Connections 中完整的分支混合算子
报告利用“分支不互相混合”这一条件,把每个读取向量精确分解到此前子层的写入。20 层模型中,一个分支持续保留早期 GDN 输出并把信息送到后续全局 attention 层,其余三个分支主要承担局部连接;五个 GR checkpoint 都出现一个长距离分支。这个分析支持“GR 重新分配跨层路径”的解释,同时没有证明所有模型规模都会形成相同语义分工。
推理实现将四分支残差状态保存为 FP8,并把 group RMSNorm 融入读取 kernel,读写各遍历一次残差状态。作者也测试过只读取门控最高的两个分支;该方案在预训练 loss 和评测上接近完整读取,后训练质量出现清晰退化,最终保留全部四个分支。
8. N-gram 查表容量与稀疏专家容量
N-gram Embedding 用当前位置结尾的二元组和三元组确定查表地址,并把向量加入第 2 层表示。确定性地址使表项可以提前预取,51B 参数可放在主机内存,并与第 1 层计算重叠。新增参数主要增加查找容量,每个 token 访问的表项数量保持有限,因此附加矩阵 FLOPs 很小。
单层放置消融显示,第 2 层在相同 N-gram 参数预算下达到 47.94 的九项平均分,高于无 N-gram 的 45.44;将同一预算分散到第 2 层和第 25 层得到 47.75,没有形成稳定增益。第 2 层还给主机预取留出一层计算时间,因而成为能力与系统接口共同决定的放置点。
固定总参数预算、增加 N-gram 表并相应减少 MoE 专家时,loss 最优点约位于基础词表十倍、N-gram 参数占比约四分之一,但域外困惑度和下游评测没有稳定超过纯 MoE 基线。保持 MoE 规模、额外增加 N-gram 表时,词表从无扩展到两百倍使 loss 从 1.585 单调降到 1.526,多个下游指标在更早位置饱和或波动,C-Eval 和 CMMLU 则随词表扩大较稳定地提高。这组结果支持两种容量的功能差异:MoE 专家提供输入相关的非线性变换,N-gram 表提供局部模式记忆;总参数量相同不构成能力等价条件。
9. Muon 分工、标度律与稳定性压力测试
Muon 被分配给真正表示二维线性映射的权重,包括 attention 和 GDN 的主要输入输出投影、路由专家与共享专家的 fc1/fc2、N-gram 层中的键值投影。输入嵌入、输出头、MoE Router 和 GR 低秩投影继续使用 AdamW,N-gram 查找表使用不带权重衰减的 Adam。报告观察到 Muon 会加剧 Router 早期波动,对细长的 GR 低秩矩阵也没有优势。
Megatron-LM 将 QKV、SwiGLU gate/up 和 GDN 输入投影存为融合矩阵。报告在 Newton–Schulz 正交化前按真实线性映射拆分这些张量:QKV 和 GDN 按 head 拆分,SwiGLU fc1 拆为 gate 与 up。该处理避免正交化混合无关子映射的奇异方向,也使形状相关的更新缩放使用正确矩阵尺寸。正式配方使用 Nesterov 动量 0.95、Polar Express 系数和八次 Newton–Schulz 迭代;Canzona 按正交化 FLOPs 重分配数据并行参数,CUDA Graph 则减少拆分后大量小 kernel 的启动开销。
新架构与优化器提高了可用学习率和批大小。10.8B-A0.89B 模型在 4T token 预算中,以新标度律预测的 25.2M batch 训练得到 1.5702 loss,旧配方 12.6M batch 为 1.5774;从 6.3M 逐步增加到 25.2M 的 batch warmup 没有改善最终结果,并增加 18.8% 优化器步数。156B-A7B 模型在 419B token 对照中,新预测设置的七项平均分为 60.55,旧 Qwen3.5 配方为 56.41;预测点附近的学习率上下变化一个
压力测试把 25B-A3B 模型学习率固定在最优值的两倍或四倍。在四倍设置中,AdamW + Qwen3.5 结构每一万步出现 183 次 loss spike,并在 19,932 步中触发 213 次梯度裁剪;两个 Muon 设置均未越过裁剪阈值,Muon + GR 记录到零次 loss spike。单独切换 GatedNorm 的对照在三倍学习率下把 spike 频率从每一万步 32.0 次降到 3.2 次,阈值越界从 256 次降到 20 次。该对照支持乘性门控提供显式重缩放的解释,仍需在其它模型家族和更完整训练日志中复验其普遍性。
10. 结论链条
在 GDN 能以固定状态连续压缩历史、QSA 能从微块索引恢复重要 token、GR 能为深度方向分配具体信息路径、N-gram 预取能被主干计算覆盖、Muon 的参数边界和新超参数处于稳定区间这些条件下,Qwen3.8-Flash-Next 同时降低主干激活计算、长上下文 attention 和训练优化成本。架构、数据与训练配方的合并结果使 125B-A6B 基座模型在十四项预训练评测中有八项超过 Qwen3.7-Plus-Base,其余差距不超过 2.6 分。
该结果支持“新配方取得更好的能力—成本折中”,证据无法拆出每个组件对正式 125B 模型最终能力的独立净贡献。约九分之一训练 FLOPs 来自三分之一激活参数与三分之一训练 token 的近似合并口径;报告未给完整 GPU 时数、能耗、数据组成和端到端服务账本。
关键实验/定理
结果 1:GDN 混合架构
- 设置:28 层 25B-A3B MoE;先在 4K 上下文训练 400B tokens,再在 32K 上下文训练 80B tokens。
- Baseline:完整注意力 Transformer;每四层保留一层完整注意力、其余使用窗口 128 的 SWA Hybrid。
- 对照是否可比:三种模型使用相同规模、训练 token 和评测流水线;组件差异集中在 token mixer。
- 指标:MMLU、MMLU-Pro、SuperGPQA、MATH、GSM8K、BBH、MMMLU、EvalPlus、MultiPL-E 的无权平均分。
- 结果:Full Attention 为 49.87,SWA Hybrid 为 51.15,GDN Hybrid 为 53.81;GDN 在九项中的八项超过完整注意力,在七项超过 SWA。
- 证据定位:Section 2.1.1,Table 1,pages 4–5。
- 支持的最窄结论:在该 25B-A3B、480B-token 设置中,三层 GDN 与一层全局 attention 的混合结构获得最高九项平均分。
- 解读:结果支持混合 token-mixing 方向;EvalPlus 上 SWA 更高,MMLU 上两种混合结构接近,单项任务没有形成一致排序。
结果 2:QSA 的能力保持与长上下文内核效率
- 设置:Qwen3.8-Flash-Next 的完整 attention 与 QSA 版本;QSA 在 256K 继续预训练中经过 2B-token 索引蒸馏和约 200B-token 稀疏联合训练。
- Baseline:同主干完整 attention 版本;长上下文额外比较 RULER 与 8-needle MRCR。
- 对照是否可比:报告称使用相同评测流水线;QSA 版本接受额外稀疏适配,结果包含结构和适配训练的合并影响。
- 指标:八项短上下文平均分、RULER、MRCR;attention kernel prefill 与 decode latency。
- 系统条件:prefill 使用 batch size 1、16K chunk;decode 使用 batch size 4、
next_n=4,包含三个 MTP 预测步;稠密基线为 FlashInfer paged GQA。 - 结果:短上下文平均分从 75.9 提高到 76.8;RULER 512K–1M 从 90.08 提高到 93.00;MRCR 512K 从 30.66 提高到 40.53,1M 从 20.71 提高到 26.44;1M attention kernel 的 prefill 与 decode 分别加速 7.6 倍和 4.9 倍。
- 指标定义:kernel latency 只覆盖索引器与 sparse core attention;不覆盖整模型 MoE、GR、通信和 N-gram 预取。
- 成本归因:长上下文收益来自键序列四倍压缩、固定 2048-token 稀疏预算和 MTP 索引复用。
- 证据定位:Section 2.1.2,Tables 2–4,Figures 4–6,pages 6–9。
- 支持的最窄结论:在报告实现和联合适配下,QSA 保持短上下文平均能力并降低长上下文 attention 模块时延;1M MRCR 的绝对分数仍显示精确多目标检索存在明显失败区间。
结果 3:Gated Residual 的能力、信息路径和稳定性
- 设置:25B-A3B MoE 训练 560B tokens 的残差消融;另在 20 层模型中分解跨层路径,并在五个 GR checkpoint 检查分支模式。
- Baseline:PreNorm、静态 mHC、动态 mHC。
- 对照是否可比:主残差消融采用同模型规模和评测流水线;路径分解使用较小 20 层模型,不能直接代表正式 48 层模型的全部内部结构。
- 指标:训练 loss、九项平均分、跨层贡献份额。
- 结果:PreNorm、静态 mHC、动态 mHC 和 GR 的 loss 分别为 1.617、1.596、1.594、1.590,平均分分别为 50.91、52.49、54.47、54.66;每个 checkpoint 均出现一个主要承担长距离连接的分支。
- 证据定位:Section 2.2,Tables 5–6,Figure 7,pages 10–14。
- 支持的最窄结论:四分支宽度与数据依赖读写共同改善该规模模型,GR 在保持动态 mHC 能力的同时移除完整分支混合;路径分析与“GR 选择性放大少量跨层连接”的解释一致。
- 解读:静态到动态的 loss 只改善 0.002,平均分提高 1.98,说明 loss 会低估数据依赖读写的下游价值。
结果 4:N-gram 参数不能按总量等价替换 MoE 参数
- 设置:先在固定 N-gram 参数预算下改变插入层,再进行两组词表缩放;一组保持总参数固定并减少专家,一组保持 MoE 不变并额外增加 N-gram 参数。
- Baseline:无 N-gram Embedding;纯 MoE 参数分配。
- 对照是否可比:插入位置实验固定 N-gram 参数;固定总参数实验改变专家数,额外参数实验改变总参数,两类结果需要分开解释。
- 指标:训练 loss、Uncheatable PPL、知识、STEM、推理、中文和多语评测。
- 结果:第 2 层单层放置平均分 47.94,无 N-gram 为 45.44;固定总参数时 loss 最优约在十倍基础词表,但下游没有稳定超过纯 MoE;额外扩表从无到两百倍使 loss 从 1.585 降到 1.526,下游指标较早饱和或波动,C-Eval 与 CMMLU 较稳定提高。
- 证据定位:Section 2.3,Tables 7–9,pages 14–15。
- 支持的最窄结论:N-gram 查表适合增加低计算成本的局部模式容量,其参数与 MoE 专家参数没有形成一比一能力替换关系。
- 解读:51B 查表参数应与主干激活参数分开报告;loss 的单调改善不能直接推出下游能力同比例改善。
结果 5:新超参数区间与门控稳定性
- 设置:10.8B-A0.89B 模型训练 4T tokens 检查 batch;156B-A7B 模型训练 419B tokens 检查学习率;25B-A3B 模型以恒定的两倍和四倍最优学习率进行压力测试。
- Baseline:Qwen3.5 超参数配方;AdamW + Qwen3.5 结构;Muon + Qwen3.5 结构。
- 对照是否可比:每组内部保持 token 预算或压力条件一致;batch、学习率和稳定性结论来自三个模型规模,属于跨规模组合证据。
- 指标:最终 loss、七项平均分、每一万步 loss spike、梯度裁剪阈值越界、预裁剪梯度范数。
- 结果:25.2M 目标 batch 的 loss 为 1.5702,旧配方 12.6M 为 1.5774;batch warmup 增加 18.8% 优化器步数且没有改善结果;156B-A7B 新预测设置平均分 60.55,旧配方 56.41;四倍学习率下 AdamW 旧结构每一万步 183 次 spike,Muon + GR 为零次。单变量 GatedNorm 对照把三倍学习率下的 spike 从 32.0 降到 3.2 次/万步。
- 证据定位:Section 3.2,Section 3.3,Table 10,Figure 8–13,pages 17–22。
- 支持的最窄结论:在报告检查的模型和 token 预算中,新架构与 Muon 对应更大的稳定 batch 和学习率区间,batch warmup 没有带来收益,门控是压力测试稳定性改善的重要组成。
结果 6:正式基座模型的能力—成本折中
- 设置:Qwen3.8-Flash-Next-Base 与 Qwen3.8-27B-Base、Qwen3.7-Plus-Base 的十四项基座模型评测。
- Baseline:27B dense 基座;397B 总参数、17B 激活参数的上一代 Plus 基座。
- 对照是否可比:报告使用统一评测协议;模型训练数据、训练 token 和架构不同,因此结果支持整套配方比较,不能拆分单个组件净贡献。
- 指标:通识、数学与 STEM、代码和多语共十四项评测。
- 结果:Flash-Next 在全部十四项超过 27B 基线,在八项超过 Qwen3.7-Plus;其余六项最大差距为 MultiPL-E 的 2.59 分。主干激活参数约为前代三分之一,训练 token 约为三分之一,报告据此估算训练 FLOPs 约为九分之一。
- 系统条件:报告未披露硬件、GPU 时数、实际 wall-clock、能耗或完整通信成本。
- 成本归因:九分之一是激活参数比例与训练 token 比例的近似组合,未单列 Muon、N-gram 更新和利用率差异。
- 证据定位:Section 4,Table 11,pages 22–23。
- 支持的最窄结论:完整 Qwen3.8-Flash-Next 配方在报告评测中取得比 Qwen3.7-Plus 更低训练计算量下的相近或更高基座能力。
实验设置与 baseline 审计
| 维度 | 记录 |
|---|---|
| 正式模型 | 125B 主模型、6B activated;另有 51B N-gram Embedding 与约 4B MTP |
| 架构消融规模 | 主要使用 20–28 层、25B-A3B 模型;N-gram、GR、QSA 和稳定性使用不同训练阶段与 token 预算 |
| 长上下文训练 | QSA Stage 1 约 2B tokens;Stage 2 约 200B tokens;序列长度 256K |
| 优化器 | Muon + AdamW/Adam 分工;八次 Newton–Schulz;融合矩阵按真实线性映射拆分 |
| 评测协议 | Base 模型主表覆盖十四项;多数主表没有多 seed、误差线或置信区间 |
| 服务测量 | 披露 GDN 与 QSA kernel 级结果;没有完整模型端到端吞吐、并发、TTFT、显存和主机带宽测量 |
| 数据披露 | 没有完整预训练数据组成、精确总 token、污染审计和版权来源账本 |
| 成本披露 | 以激活参数、token 比例、内核时延和优化器步数为主;没有 GPU hours、能耗和货币成本 |
| 发布模型边界 | 技术报告主要评测 Base 模型;公开 Hugging Face checkpoint 为后训练原生多模态模型,后训练数据和强化学习配方未披露 |
- 未披露项:完整预训练数据账本、正式训练总 token、硬件拓扑、GPU 时数、wall-clock、能耗、端到端服务成本、后训练配方、视觉训练配方和多数评测的随机种子区间。
证据链强度评估
强证据
- 官方技术报告、模型权重、配置、GitHub 仓库和模型卡均已公开,模型结构与发布口径可以交叉核对。
- QSA 给出了两阶段训练、短上下文能力、长上下文检索和内核时延四类相邻证据。
- GR 同时给出模块消融、跨层路径分解、压力测试和生产训练早期统计,证据覆盖能力与稳定性。
- 报告保留 NoPE、残差分支稀疏读取和 batch warmup 等后期失败结果,使最终设计边界可以定位。
中等强度证据
- 正式基座模型相对 Qwen3.7-Plus 的能力—训练 FLOPs 折中来自统一主表和报告成本近似,但缺少数据与硬件账本。
- QSA 在 1M 的速度来自 attention kernel;整模型收益需要额外系统测量。
- 一个长距离 GR 分支的解释在五个 checkpoint 中重复出现,主要证据仍来自较小 20 层模型。
需要谨慎的推论
- 报告是 Qwen4 架构预览,最终 Qwen4 的模块、规模和训练配方仍可能变化。
- 小于一分的 benchmark 排序缺少重复运行与统计区间,不适合解释为稳定能力差异。
- N-gram 主机卸载的收益依赖硬件拓扑、batch 和预取实现,报告没有证明所有部署环境都能隐藏传输成本。
- 公开后训练模型的智能体和视觉评测来自发布页,含内部 benchmark、修订题集和不同 harness,不构成技术报告 Base 消融的直接延伸。
主要启发
1. 大模型容量需要按计算、状态与查表记忆三个坐标记录
这篇报告中,MoE 总参数、每 token 激活参数、GDN 固定状态、QSA 访问预算和 51B N-gram 表分别影响权重容量、矩阵 FLOPs、时间状态、长上下文检索与主机存储。固定总参数实验中,用 N-gram 参数替换专家没有稳定提高下游能力;保持专家不变并额外扩表时,loss 单调下降而多项评测较早饱和。这些证据说明总参数相同不代表容量功能相同,6B 激活参数也不能直接推出权重驻留需求。证据定位:Section 2.3,Table 8,Table 9,pages 14–15。
可迁移的关系是:当任务包含可由局部离散模式寻址的重复信息、主机带宽足以覆盖预取且矩阵计算是主要成本时,查表记忆可以用较少 FLOPs增加容量;当目标依赖长距离组合或地址冲突较多时,新增表项的下游收益会早于 loss 饱和。可证伪预测是在相同激活 FLOPs 下,局部模式密集的数据会从 N-gram 扩表获得更明显收益,打乱局部 token 顺序的数据不会保持同等增益。
2. 架构消融需要覆盖后训练行为与压力区间
NoPE 在预训练阶段与 RoPE 接近,后训练后无限生成比例更高;只读两个残差分支在预训练 loss 和评测上接近完整读取,后训练质量下降;动态残差读写只带来 0.002 loss 改善,九项平均分提高 1.98。三组结果共同表明,预训练 loss 对生成终止、后训练可塑性和下游路径选择的分辨率有限。证据定位:Section 2.1.1,Section 2.2,Table 5,pages 4、11、14。
可迁移的关系是:架构改动若改变状态读取、位置表示或门控,其失败可能在后训练和生成阶段才出现。其它模型上的可证伪预测是:预训练 loss 近似的状态稀疏化与位置编码变体,在短周期 SFT、长生成终止率和高学习率压力测试中会形成更大的排序差异。该判断来自报告的真实失败反馈,具体阈值仍依赖模型家族与训练配方。
3. 显式门控把高学习率所需的重缩放变成可训练接口
单独启用 GatedNorm 时,三倍最优学习率下的 loss spike 从每一万步 32.0 次降到 3.2 次,梯度阈值越界从 256 次降到 20 次;GR 还降低残差激活最大值和梯度范数波动。作者据此将无门控模型中的大激活解释为隐式重缩放,并用乘性 gate 提供受输入控制的显式路径。证据定位:Section 3.3,Figure 11,Figure 12,pages 20–21。
抽象关系是:当优化步长提高并要求网络重新分配激活尺度时,受限乘性门控可以降低通过异常值完成缩放的需求。迁移到其它深层或循环架构时,可检查的预测是:保持优化器、数据顺序和学习率一致,加入边界明确的读门控后,激活极值、梯度范数高分位数和 loss spike 会同步下降;若三项没有共同变化,这一机制解释就需要修正。
局限
- 报告的正式模型是原生多模态模型,方法和消融集中在语言主干;视觉编码器、视觉 token 接口、多模态数据与多模态训练过程没有对应消融。
- 完整预训练数据组成、精确总 token、去重、污染控制、版权来源、硬件拓扑、GPU 时数、能耗和 wall-clock 均未披露,约九分之一训练 FLOPs 只能按报告口径解释。
- GDN、GR、N-gram、标度律和稳定性实验使用不同模型规模与训练预算;组合证据支持完整配方,不能相加得到各组件在正式 125B 模型上的独立贡献。
- 多数 benchmark 没有重复运行、随机种子、误差线或置信区间,小幅差异可能落在评测噪声内。
- QSA 索引器在固定压缩比下仍具有二次渐近复杂度;1M MRCR 得分为 26.44,百万 token 多目标精确检索仍有明显失败区间。
- QSA 的主要速度证据是 attention kernel 测量,N-gram 的系统主张依赖异步主机预取;整模型 TTFT、吞吐、并发、显存、主机内存带宽和设备间通信没有统一测量。
- 技术报告第 4 节主要评测 Base 模型;公开 checkpoint 是后训练模型,后训练数据、强化学习、视觉训练和安全对齐配方未披露。
- 模型采用 Qwen Community License 1.0;商业 MaaS 和面向编码或办公的 AI 工作助手需要按许可证取得额外授权,部署边界不同于 Apache 2.0 模型。
跨论文关系
- 与已有论文的作者或机构关系:本文与 Qwen3、Qwen3-Coder-Next 和 Bebop 共享 Qwen Team / Alibaba Group 网络;Rui Men、Bo Zheng、Dayiheng Liu、Fan Zhou、Jianwei Zhang 等作者构成已存档工作的直接连接。
- 与已有论文的主题关系:Kimi K3 同样组合线性 attention、周期性全局 attention、MoE 与跨层残差机制;本文进一步把微块级稀疏 attention、N-gram 查表和 Muon 配方放入同一能力—成本—稳定性验收框架。
- 与已有论文的方法或系统关系:QSA 与 DeepSeek-V3.2 的 DSA、IndexCache 的跨层索引复用共同处理稀疏 attention 索引成本;QSA 选择层内微块压缩。GR 与 Attention Residuals 都增加深度方向的可选读取路径,GR 使用四个固定分支和逐通道门控。N-gram Embedding 与 Engram 共享条件查表记忆路线;Muon 稳定性结果与 Muon Curvature 的优化器分析形成训练机制连接,MTP 索引复用则与 Bebop 的多 token 预测训练线相接。