阅读笔记
Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning
本文在同一训练框架下、覆盖范围并不完全重合的 Qwen3 4B/8B Base 与对齐后数学强化学习实验中,分别检查优势归一化、概率比裁剪、损失聚合和超长过滤,得到“依据奖励方差、裁剪触发率和响应长度分布选择技术”的主要经验,并将组内均值—批级标准差归一化与 token 级损失组成不训练价值模型的 Lite PPO;OpenReview 补充的一个 Qwen3-8B Base 三随机种子设置仍优于 GRPO 与 DAPO,奖励范围异常、训练预算矛盾、未对齐计算量和有限模型任务覆盖限制其普适性。
所读版本 arXiv 2508.08221v3。ICLR 接收版标题删除 Part I:,作者列表为 15 人并未列 Johan Obando Ceron;本文按用户指定的 arXiv v3 归档,审稿补充实验单独标记。
Source
- Workflow version: v2.1
- Material type: research-paper
- Analysis modules: experiment
- Canonical source: https://arxiv.org/abs/2508.08221v3
- Title: Part I: Tricks or Traps? A Deep Dive into RL for LLM Reasoning
- Authors: Zihe Liu, Jiashun Liu, Yancheng He, Weixun Wang, Jiaheng Liu, Ling Pan, Xinyu Hu, Shaopan Xiong, Ju Huang, Jian Hu, Shengyi Huang, Johan Obando-Ceron, Siran Yang, Jiamang Wang, Wenbo Su, Bo Zheng
- Responsible organization: Alibaba Group;Beijing Jiaotong University;Hong Kong University of Science and Technology;Nanjing University;Peking University;OpenRLHF;CleanRL;Mila
- arXiv: https://arxiv.org/abs/2508.08221v3
- HTML: https://arxiv.org/html/2508.08221v3
- PDF: https://arxiv.org/pdf/2508.08221v3
- Code/Project: https://github.com/alibaba/ROLL
- Code snapshot inspected: ROLL
5304da2f74e15429774511f1e67b2cc7ce136e65,2026-08-25 读取的main;最新 release 为v0.3.0 - OpenReview / Review page: https://openreview.net/forum?id=R0JM3BWP7W
- Submitted: 2025-08-11
- Published / updated: arXiv v3 updated 2025-10-27;ICLR 2026 Poster accepted
- Current version read: arXiv v3 HTML、PDF 与 TeX source;OpenReview submission、4 份 official review、rebuttal、meta-review 与 decision;当前 ROLL 文档和实现
- Version / revision read: arXiv
2508.08221v3。ICLR 接收版标题删除Part I:,作者列表为 15 人并未列 Johan Obando-Ceron;本文按用户指定的 arXiv v3 归档,审稿补充实验单独标记。 - Accessed: 2026-08-25
- Key figure decision: include
- License: CC BY 4.0
- Review status: page-type=official-review; match-confidence=high; observed-at=2026-08-25; venue-status=accepted-poster
- Subjects: Machine Learning (cs.LG);Computation and Language (cs.CL)
作者与关系
- Zihe Liu: Alibaba Group、Beijing Jiaotong University。
- Jiashun Liu: Alibaba Group、Hong Kong University of Science and Technology。
- Yancheng He: Alibaba Group。
- Weixun Wang: Alibaba Group。
- Jiaheng Liu: Nanjing University。
- Ling Pan: Hong Kong University of Science and Technology。
- Xinyu Hu: Alibaba Group、Peking University。
- Shaopan Xiong: Alibaba Group。
- Ju Huang: Alibaba Group。
- Jian Hu: OpenRLHF。
- Shengyi Huang: CleanRL。
- Johan Obando-Ceron: Mila。
- Siran Yang: Alibaba Group。
- Jiamang Wang: Alibaba Group。
- Wenbo Su: Alibaba Group。
- Bo Zheng: Alibaba Group。
四位共同贡献作者覆盖 Alibaba、北京交通大学和香港科技大学;Weixun Wang 同时承担通讯作者角色。本文与 ROLL、RollArt、ROLL Flash 形成直接的 Alibaba 强化学习系统与算法实验连续线,并与 Jian Hu 参与的 OpenRLHF、REINFORCE++、ProRL 和 BroRL 研究形成作者桥接。
论文脉络
1. 研究问题、背景和价值
推理模型强化学习已经积累多种常用设计:组内或批级优势归一化、非对称概率比裁剪、token 级损失、动态采样和超长回答过滤。不同论文通常把若干组件组成一个完整算法,再在不同基座、数据和生成预算上报告最终分数。组件收益因此同时受到模型初始化、奖励分布、问题难度和响应长度影响,单篇算法的总分无法回答“当前训练运行应启用哪一项技术”。
本文的研究对象是这些设计选择的适用条件。作者先在同一 ROLL/PPO 实验框架中改变一个主要因素,观察准确率、策略熵、奖励标准差、响应长度和重复率,再把在 Qwen3 Base 设置中表现较好的两个组件组成 Lite PPO。该研究形态的价值来自诊断:训练失败时,开发者可以先检查可测状态,再决定修改归一化、裁剪、损失归约或长度策略。
2. 已有解决方案与不足
GRPO 对同一 prompt 的多条回答执行组内中心化和组内标准差缩放;REINFORCE++ 等方法采用批级统计量;DAPO 同时加入 Clip-Higher、动态采样、token 级策略梯度损失和超长奖励整形。这些方法给出可运行配方,公开证据较少把组件效应与以下变量分离:
- Base 检查点与对齐后检查点的初始正确率、熵和响应长度;
- 一组 rollout 中全对、全错和混合结果的比例;
- 奖励标准差与标准差缩放后的更新尺度;
- PPO 概率比真正触及裁剪边界的 token 比例;
- 回答长度与优势符号、截断原因和重复行为的联合分布。
本文补充了多项单因素曲线和机制指标。其证据仍集中在 Qwen3 4B/8B 与可验证数学答案,主体实验使用单一随机种子。现有结果可以作为技术选择的条件化经验集,尚不足以给出算法的统一排序。
3. 作者可能的思考路径
以下为本地重构。研究可以从一个常见工程现象出发:同一技术在不同训练运行中会分别表现为稳定、无效或引发退化。若直接继续添加组件,组合效应会使原因更难定位。较低成本的路径是先固定训练框架、rollout 数、学习率与评测集,再对四类常见技术逐项改变,并同时记录技术实际作用的中间量。
这一思路进一步导向两个选择。第一,技术适用条件应由奖励分布、裁剪率和长度分布表达,使结论可以迁移到其它模型。第二,最终方法只保留在目标 Base 设置中具有直接收益的组件。Lite PPO 因而承担一次组合验证:组内均值—批级标准差归一化控制优势尺度,token 级归约改变不同长度回答的总权重。
4. 核心假设或切入点
论文依赖四项核心判断:
- 技术效果随训练状态变化,模型类型和数据难度只是这些状态的代理变量。
- 稀疏二元奖励下,优势中心与尺度可以采用不同统计范围;组内均值提供同题相对基线,批级标准差提供跨 prompt 的尺度估计。
- PPO 的裁剪上界只有在足够多 token 触发该上界时才会改变更新;策略熵可以作为探索状态的间接指标。
- sequence 级与 token 级损失的差异来自回答长度分布;长度与优势相关时,两种归约产生不同的回答总权重。
其中第一、二和四项得到相应曲线支持,但统计强度有限;第三项中的裁剪触发条件得到测量,连接词与“创新推理结构”的因果解释缺少系统指标。论文对奖励范围的主张还与标准化的正仿射不变性冲突,不能作为已确认假设。
5. 贡献全景与方法总览
首要贡献是一套按训练状态选择强化学习技术的经验框架。辅助贡献包括四类组件消融、一个只保留两项组件的 Lite PPO 配方,以及审稿阶段补充的随机种子和跨模型结果。
四类消融共享训练框架和评测集,覆盖的模型尺寸、初始化、数据档位与长度上限并未形成完整全因子设计:归一化覆盖最广,损失归约和超长过滤主要集中于 8B,最终 Lite PPO 主实验只覆盖 Base 检查点。以下链条描述共同实验逻辑,不代表所有阶段使用同一个全交叉配置矩阵。
端到端论证链由五个阶段组成:
| 阶段 | 输入与操作 | 传递对象 | 局部作用 | 输出 |
|---|---|---|---|---|
| 1. 固定基线 | Qwen3 4B/8B Base 与对齐后检查点,三档数学数据,统一 PPO 裁剪代理目标和 REINFORCE 优势 | 基线曲线、正确率分布、响应长度 | 建立不同初始化和数据条件下的训练参照 | 可比较的失败模式与可优化范围 |
| 2. 单因素干预 | 分别改变归一化、裁剪上界、损失归约和超长过滤 | 奖励标准差、裁剪率、熵、长度、重复率与准确率 | 把最终分数差异连接到可测中间状态 | 各技术的局部适用条件 |
| 3. 条件化解释 | 比较 Easy/Hard、Base/对齐后、8K/16K/20K 等设置 | 条件—效果对应关系 | 识别模型和数据标签背后的调节变量 | 实践选择规则与待验证机制 |
| 4. Lite PPO 组合 | 在无 critic、无 KL 的 PPO 裁剪目标中使用组内均值—批级标准差优势与 token 级损失 | 每条 rollout 的标量优势与逐 token 策略比 | 面向 Base 模型组合两项局部收益 | 更新后的 Base 策略 |
| 5. 基线和审稿补充评测 | 与 GRPO、DAPO 比较;审稿阶段增加三随机种子、组件消融和一个 Llama3 设置 | 六项数学准确率及领域外最终策略评测 | 检查组合收益、随机性与部分外部有效性 | Lite PPO 的局部有效性结论 |
这里的“PPO”指采用 PPO 概率比裁剪代理目标、以 REINFORCE 回报形成优势且不训练价值模型的策略优化。它与训练 critic、使用 GAE 的标准 actor–critic PPO 配置不同。旧策略负责生成 rollout 并提供概率比分母,更新策略接收相同回答级奖励;Lite PPO 改变优势尺度和损失归约,没有加入 Clip-Higher、动态采样或超长过滤。
论文没有独立检验 DAPO 的动态采样,也没有检验熵奖励或 KL 系数;动态采样只存在于完整 DAPO 基线中,熵只作为 Clip-Higher 的诊断指标,Lite PPO 配置将 KL 系数设为零。因此本文不能提供这三项设计的单独收益经验。
6. 固定基线并观察数据难度
论文用 ROLL 执行全部实验。每个更新批次包含 128 个 prompt,每个 prompt 采样 8 条回答,共 1024 条 rollout;正文写最大回答长度 8192 token,附录配置写 8000。学习率为 top_p=0.99、top_k=100、temperature=0.99。附录另给出 seed=42、ppo_epochs=1、adv_estimator=reinforce 和 init_kl_coef=0。
Easy 数据从含 GSM8K 和 MATH-500 level 1 的 SimpleRL-Zoo-Data-Easy 随机取 5000 题;Medium 是 DeepMath-103K 中最容易的 5000 题;Hard 按 DeepMath 难度标签成比例抽取 5000 题。评测覆盖 MATH-500、OlympiadBench、MinervaMath、AMC23、AIME24 和 AIME25。不同难度同时改变数据来源、题型、标注和模型成功率,因此难度效应带有数据域与质量混杂。Easy 训练数据还包含 MATH-500 level 1,而评测包含 MATH-500;正文未披露去重过程。
基线曲线给出两项可复用观察。较难数据对应更稀疏的成功信号和更长的回答,Qwen3 Base 在过难设置中可能停滞或下降;对齐后检查点具有更高初始准确率和更长初始回答,论文称后续增益约为 2%,但未说明相对百分比、百分点或汇总口径。实践中应先统计每个 prompt 的 8 条 rollout 成功数分布、有效样本比例和响应长度,再决定提高难度。Easy/Hard 名称本身无法确定信息量。
7. 用局部中心与批级尺度构造优势
归一化需要同时解决两个局部问题:同一题的回答应获得相对基线,整个更新批次的梯度尺度又不应被单个 prompt 的极小标准差放大。对第
Figure 5 还比较批级中心化后保留或删除标准差项。Easy 设置的奖励标准差由约 0.47 降至约 0.22,保留标准差的运行在约 75 step 后退化,删除标准差的运行继续改善;Hard 设置的差异较小,部分后期结果反向。这里可以确认“低奖励标准差与删除缩放后的稳定曲线相关”。论文没有报告梯度范数或梯度爆炸事件,因果链中的“极小分母导致梯度爆炸”仍是待验证解释。Figure 5 的公式写同题均值,正文称 batch mean,均值统计范围也需要复现配置澄清。
v3 的版本痕迹构成一项重要异常。TeX 已把原 Takeaway 1 及 4B 奖励范围实验整体注释,但引言仍保留对应贡献并出现未解析的 §??,附录继续显示 8B 图。原主张称把二元奖励从
在样本、mask、统计范围、代码路径与随机状态相同的条件下,正仿射变换后的标准化结果应保持不变;实现中的
8. 依据实际裁剪触发率设置 Clip-Higher
PPO 裁剪作用于新旧策略的 token 概率比:
Clip-Higher 固定下界
论文测得 Base 设置中的裁剪率约为 0.003;相应实验中提高上界对策略熵影响很小,准确率经常下降。对齐后模型的熵下降更明显,提高上界后熵保持更高,多数评测得到改善。可复用经验应写成:先测量按优势符号分层的上下界触发率、熵和每步 KL/更新幅度,触发率接近零时,调整裁剪上界的直接作用有限。Base/对齐后只是当前实验里的代理标签,二者还同时改变初始技能、响应长度和 token 分布。
作者用一个案例和裁剪频率最高的 20 个 token 说明连接词可能受到上界约束。该证据没有测量推理路径的新颖性或连接词对正确性的贡献,只能生成待验证假设。论文把 Qwen3-4B 在四个上界取值下的均值趋势称为“scaling law”,而 Qwen3-8B 的最佳点约为 0.28;证据只有两个尺寸、一个模型家族、一个数据设置和单随机种子。作者在 OpenReview 回复中接受“size-dependent trend”的较窄表述,因此当前证据支持超参数敏感性,不支持缩放律。
9. 损失归约决定不同长度回答的总权重
设第
sequence 级归约令每条回答的总权重相同;token 级归约令每个 token 的权重相同,长度为
Figure 12 和 Appendix Figure 17 显示,Qwen3-8B-Base 尤其在 Hard 数据上使用 token 级归约时收敛与稳定性更好;对齐后 Qwen3-8B 的多数设置由 sequence 级归约取得更好结果。论文将差异归因于 Base 模型需要更细粒度学习、对齐后模型需要保持回答结构,这一因果解释缺少长度匹配和梯度尺度对照。实践选择应以长度分布、长度—奖励相关性和分层梯度贡献为依据;模型类型只提供当前证据中的初始线索。
10. 超长过滤同时改变样本选择、长度压力和计算量
论文把超长过滤描述为屏蔽达到最大生成长度回答的奖励信号,但未给出奖励、优势和损失之间的执行顺序。若只把原始奖励设为零,后续组内中心化仍可能给该回答非零优势;真正的样本过滤需要确保相应 token 不进入最终策略损失。该操作旨在减少截断样本产生的错误负信号,也使策略更少接收长回答的更新。论文在 Qwen3-8B Base 的 8K、16K、20K 上限和 Qwen3-8B 对齐后模型的 8K 上限中比较过滤与不过滤。
8K 设置下,过滤与更高准确率、较短输出和较低的后期退化相关;上限增加到 20K 后,准确率收益缩小,过滤运行有时生成更长回答。对齐后 8K 设置中,未过滤运行的“正确答案后无停止重复”比例由约 0.1–0.18 升至约 0.4–0.55,过滤运行保持较低。该结果支持在当前阈值下同时检查准确率、截断率和重复率。
8K、16K 和 20K 同时改变有效样本集合、长度压力与 rollout token 成本,无法单独代表任务是否需要长推理。论文的重复率只在超长样本内计算,缺少各组分母、EOS 校准与有效长推理识别。部署配方应根据“达到上限的回答中,有效推理、错误推理和无停止重复各占多少”设置阈值;单一长度上限不足以确定过滤收益。
这一实验还揭示规则奖励的数据卫生问题:二元答案题可能凭错误过程猜中 True/False,模型也可能先给出正确答案再持续重复直到截断,两类轨迹都可能获得奖励 1。训练监控需要联合记录最终答案正确性、终止状态、重复率、响应长度和可验证过程质量。论文删除了过多 True/False 样本,但未披露规则和数量。
11. Lite PPO 组合与审稿补充证据
Lite PPO 在本文的 Base 设置中只保留两项改变:用组内均值和批级标准差构造回答级优势,用 token 级方式归约 PPO 裁剪损失。训练不使用 critic 或 KL,附录配置只有一个 PPO epoch。Clip-Higher、动态采样和超长过滤均未进入基础 Lite PPO 配方。
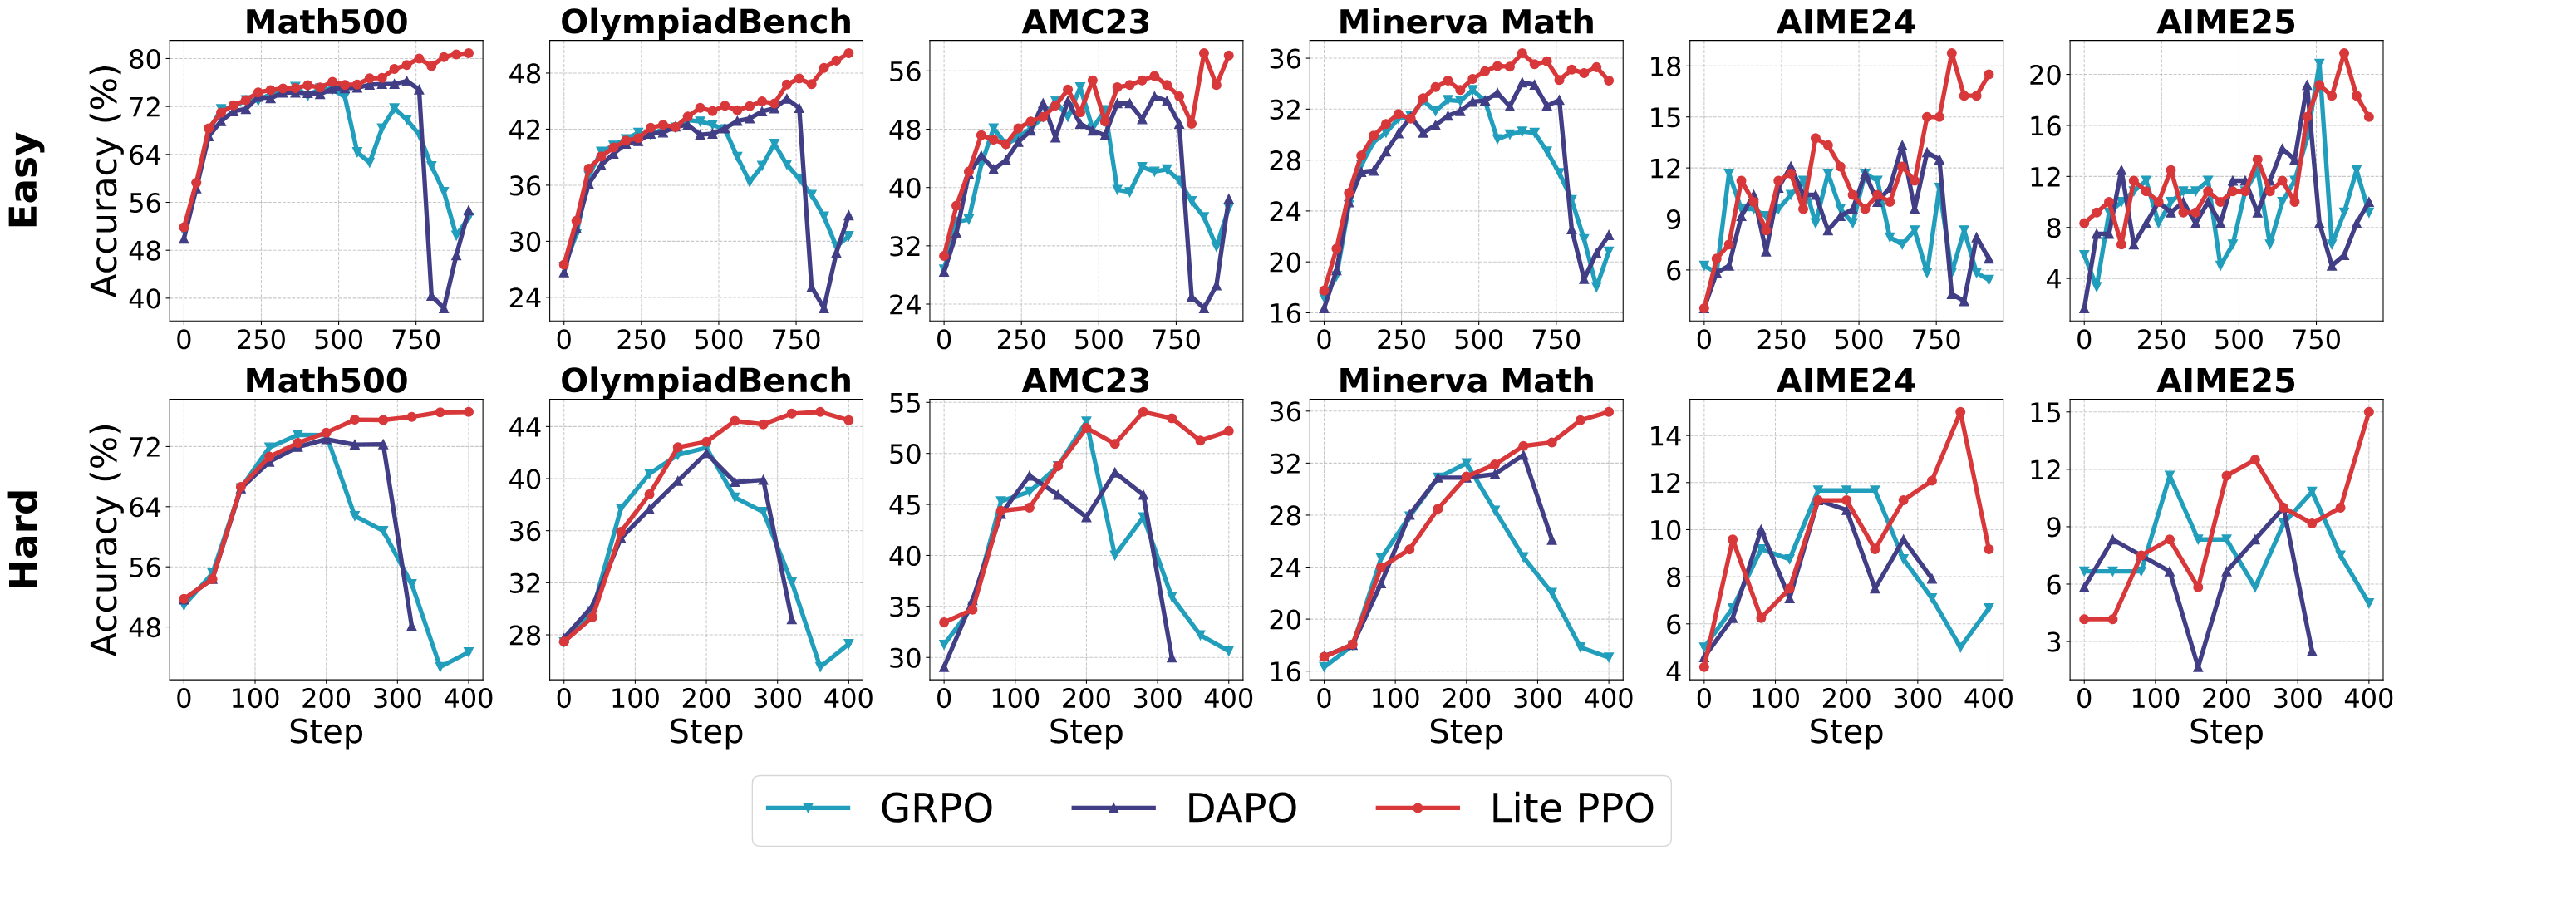

overall_4b_base.svg.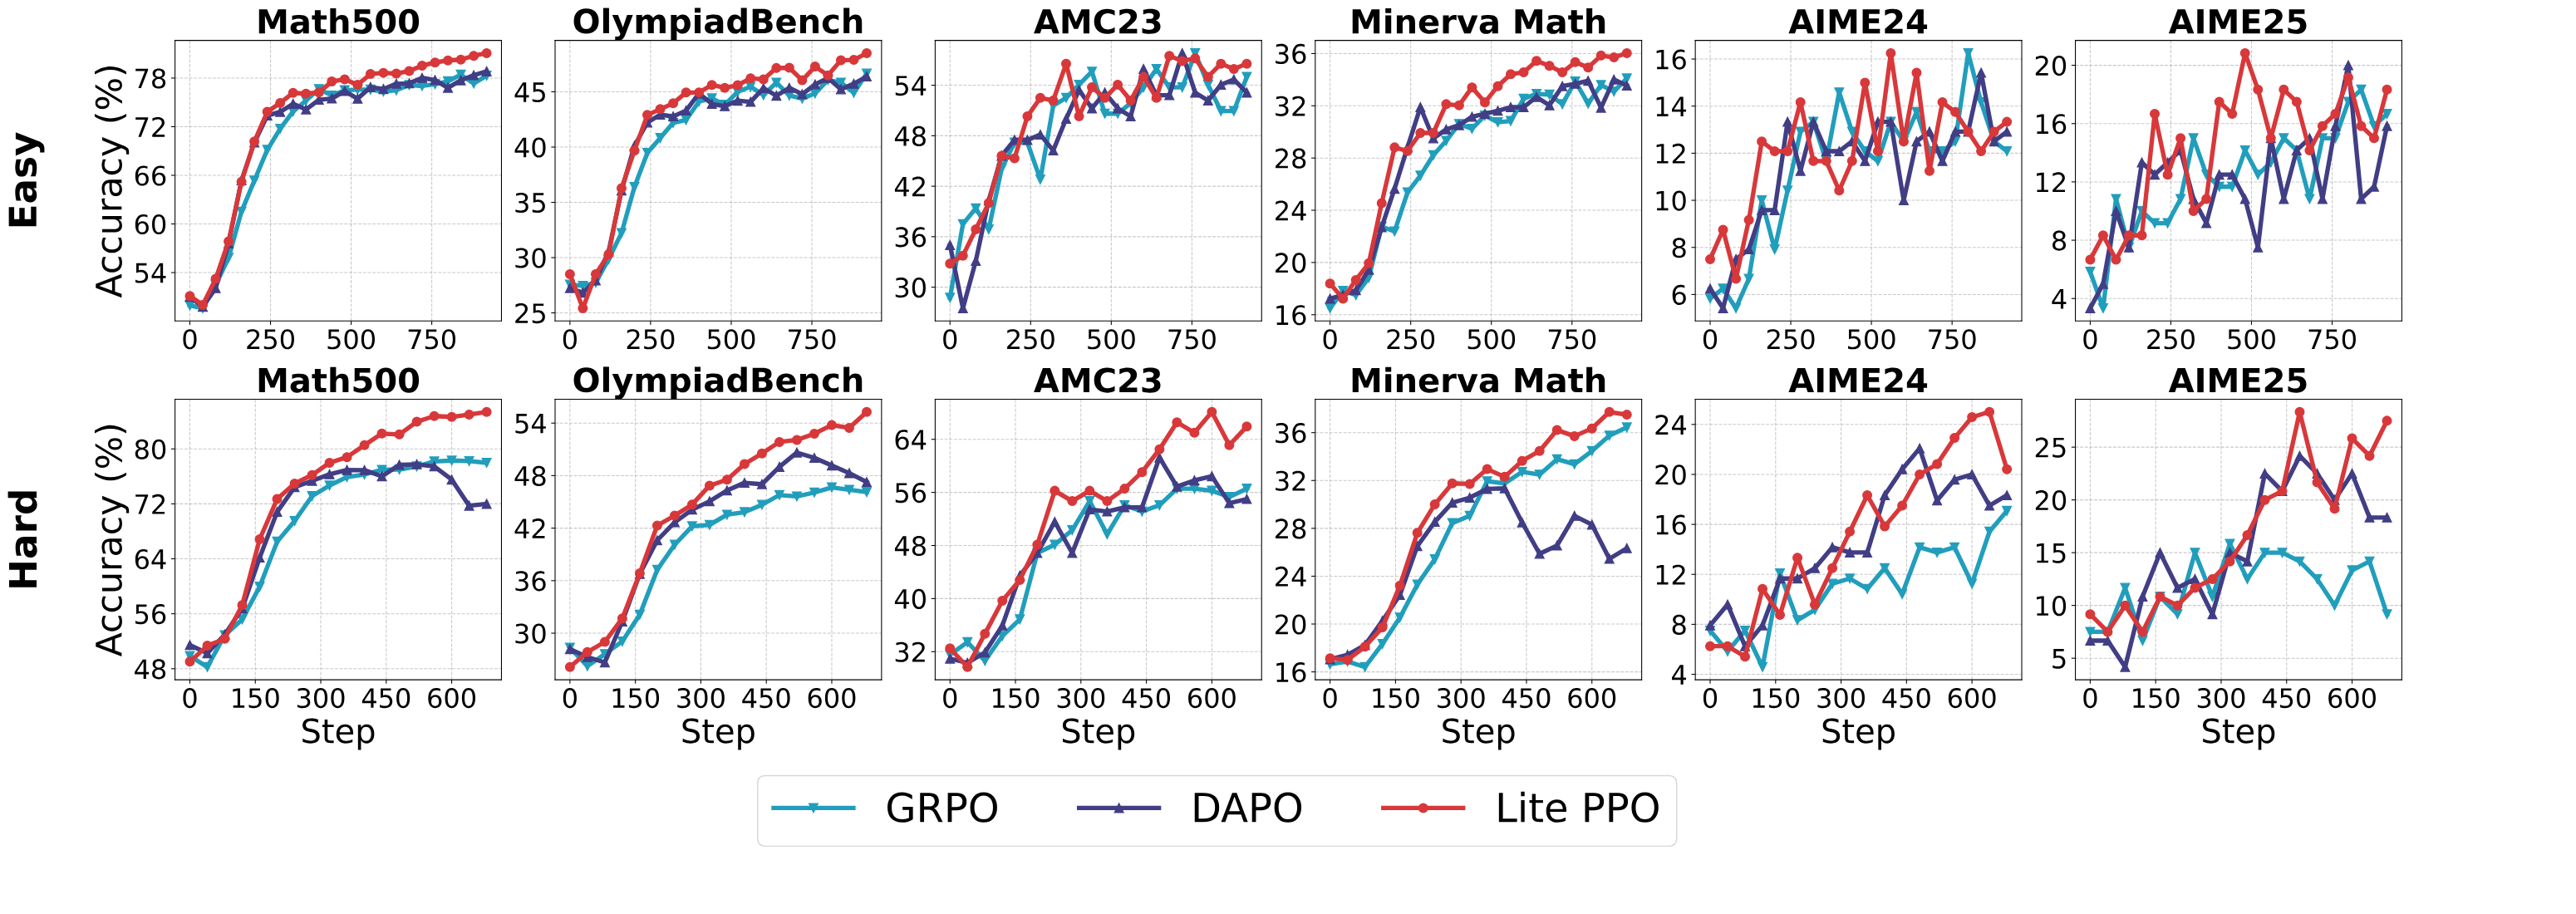

overall_8b_base.svg.arXiv v3 Figure 15 显示,Lite PPO 在 Qwen3-4B-Base 的两档数据上避免了 GRPO/DAPO 的后期退化;Qwen3-8B-Base Hard 的最终均值也更高。图中只包含单种子曲线,没有最终数值表、置信区间或 checkpoint 选择规则;部分曲线超过附录 max_steps=500,达到约 800–2000 step。按 step 比较也未对齐实际 rollout token,DAPO 的动态采样会改变生成量。
OpenReview rebuttal 补充了一个 Qwen3-8B-Base Hard 三随机种子结果,作者回复报告的六项数学评测均值为:
| 方法 | 作者回复报告的三随机种子均值 ± 离散量 |
|---|---|
| GRPO | 42.17 ± 0.35 |
| DAPO | 44.77 ± 0.33 |
| Lite PPO | 49.44 ± 0.89 |
作者回复没有说明 ± 表示跨种子标准差、标准误或其它离散量。同一设置的组件消融报告 Lite PPO 49.64,删除 token 级损失为 42.82,删除混合归一化为 36.19,把批级标准差改回组内标准差为 41.86。这组结果加强了两项组件在一个 Qwen3-8B-Base Hard 配置中的联合贡献证据。它没有构成完整
回复另报告 Llama3-8B 单一数学设置的 GRPO、DAPO、Lite PPO 均值分别为 22.63、23.67、25.53,形成一个跨模型家族补充结果;回复没有披露其随机种子、完整配置和 checkpoint 规则。数学训练后的 Qwen3-8B-Base 在 LiveCodeBench、GPQA、MMLU-Pro 汇总均值上由 36.38/37.17 提高到 Lite PPO 的 38.45,验证的是最终策略迁移,未在非数学训练中重新比较各项技术。对齐后版本还加入 Clip-Higher,配方已超出原始两组件定义。
当前 ROLL 仓库实现了“组内均值、批级标准差”的统计选项,公开文档中的 Lite PPO 示例仍包含 GAE/critic、单回答组、KL 和 sequence 级聚合等通用配置;仓库未提供与论文逐项一致的 Lite PPO 实验 YAML。论文结果应绑定其附录设置与 arXiv v3,不能用当前通用示例直接替代。
12. 结论链条与强化学习实践摘要
论文最有价值的结论是技术选择需要连接到可测状态。以下经验按当前证据强度排列:
| 训练现象 | 优先测量 | 当前证据支持的操作 | 会改变结论的边界 |
|---|---|---|---|
| rollout 近乎全对或全错 | 每题成功数、批级奖励标准差、有效优势比例 | 组内中心化配合批级尺度;奖励标准差很低时比较删除标准差缩放 | 需要梯度范数、更多种子和统计范围明确化 |
| 提高 PPO 上界后无变化 | 正负优势 token 的裁剪触发率、熵、KL | 触发率接近零时保留原上界;触发率较高且熵快速下降时再搜索上界 | 当前只覆盖 Qwen3 4B/8B;连接词机制与缩放律未确认 |
| 长回答学习不足或训练退化 | 长度分布、长度—优势相关性、分层梯度贡献 | Base/长回答设置中比较 token 级归约;对齐后设置同时保留 sequence 级对照 | 两种归约在等长回答时相同,模型标签不提供因果判据 |
| 达到长度上限的样本增多 | 总截断率、有效长推理比例、无停止重复率、rollout token | 在有效短中程任务中搜索过滤阈值;分别处理重复输出与有效长推理 | 阈值会改变样本选择、长度压力和计算量 |
| 规则奖励继续上升但回答质量异常 | 答案正确性、终止、重复、长度和过程有效性 | 清理二元答案噪声,联合监控终止行为与正确率 | 论文未披露过滤规则、数量和过程验证器 |
| 组合方法优于基线 | 组件消融、多随机种子、实际生成 token 与 checkpoint 规则 | Lite PPO 可作为 Qwen3 Base 数学可验证奖励强化学习(RLVR)的简洁起点 | 跨任务、跨家族和对齐后配方证据仍有限 |
从假设到结论的最窄链条为:不同训练设置产生不同的奖励、概率比和长度分布;这些分布决定组件如何改写优化信号,并与最终收益呈现当前设置下的条件关系;Qwen3 单因素曲线支持多项条件化观察;两个局部有效组件在 Base 设置中组成 Lite PPO,并在一个三随机种子补充实验和一个 Llama3 单设置中保持优势。由此可以把 Lite PPO 视为 Qwen3 Base 数学 RLVR 的候选默认起点,同时保留针对实际训练状态的消融。现有证据尚不足以给出面向所有 LLM 强化学习的固定配方。
关键实验/定理
结果 1:数据难度与初始化改变训练动态
- 设置:Qwen3-4B/8B Base 与对齐后检查点;Easy、Medium、Hard 各 5000 题;每题 8 条 rollout。
- Baseline:统一无 critic PPO 裁剪目标与 REINFORCE 优势。
- 指标:六项数学评测准确率、训练准确率、响应长度和每题正确 rollout 数。
- 结果:Hard 数据对应更长回答和更稀疏成功信号,Base 模型可能退化;对齐后检查点初始分数更高,论文称进一步训练约提高 2%,但未说明相对百分比、百分点或汇总口径。
- 对照是否可比:模型尺寸内训练超参数统一;三档数据来源和题型不同,难度与数据域、标注质量共同变化。
- 证据定位:Section 4.1–4.2,Figure 2–3,Appendix A;arXiv v3 HTML。
- 支持的最窄结论:在所测 Qwen3 数学设置中,训练数据的当前成功率分布和响应长度与可学习性相关。
- 解读:选题应依据策略当前的 rollout 分布,静态难度标签只提供粗略先验。
结果 2:归一化的统计范围影响稳定性
- 设置:Qwen3 4B/8B Base 与对齐后检查点;组内、批级、无归一化及混合统计范围。
- Baseline:组内均值与组内标准差、批级均值与批级标准差、无归一化。
- 指标:六项准确率、奖励标准差和训练曲线。
- 结果:组内均值—批级标准差在多项 Base 设置中曲线较稳;Easy 设置奖励标准差下降时,删除标准差缩放与避免退化相关;Hard 设置差异缩小。
- 对照是否可比:单因素设置大体统一;主体只有
seed=42,均值范围描述存在歧义,图中阴影是单轨迹时间窗波动。 - 证据定位:Section 5.1,Figure 4–6,Appendix Figure 18;arXiv v3 HTML。
- 支持的最窄结论:在所测稀疏二元奖励设置中,优势中心化和缩放的统计范围会改变训练轨迹,低批级奖励标准差是需要检查缩放方式的信号。
- 解读:在样本、mask、统计范围和代码路径相同的条件下,奖励范围归因与 z-score 仿射不变性冲突;当前结果原因未查明,不能作为可用经验。
结果 3:Clip-Higher 的效果与裁剪触发率相关
- 设置:Qwen3 4B/8B Base 与对齐后检查点;上界取值覆盖 0.20 至 0.32。
- Baseline:对称 0.20 裁剪和 DAPO 常用 0.28 上界。
- 指标:准确率、策略熵、裁剪率、token 概率与高频触发 token。
- 结果:Base 裁剪率约 0.003,提高上界影响较小并常降低准确率;对齐后设置保持更高熵并在多数指标改善。4B/8B 最佳上界不同。
- 对照是否可比:模型尺寸内训练设置统一;Base 与对齐后模型同时改变初始能力、熵、长度和 token 分布,单随机种子限制趋势判断。
- 证据定位:Section 5.2,Figure 7–11,Appendix Figure 19–20;arXiv v3 HTML。
- 支持的最窄结论:裁剪触发率接近零时,提高上界对代理目标的直接影响很小;较高触发率和快速熵下降构成搜索上界的实验条件。
- 解读:两个尺寸和四个取值只支持尺寸相关超参数趋势,无法建立缩放律。
结果 4:损失归约与超长过滤受长度分布调节
- 设置:Qwen3-8B Base/对齐后模型比较 sequence/token 级归约;Qwen3-8B 在 8K、16K、20K 上限比较超长过滤。
- Baseline:sequence 级等回答权重;不过滤超长回答。
- 指标:六项准确率、响应长度、截断样本中的重复率。
- 结果:token 级归约在 Base 尤其 Hard 设置中更稳,对齐后多数设置由 sequence 级归约更优;超长过滤在 8K 的收益明显,在 20K 缩小。
- 对照是否可比:归约实验未匹配回答长度和梯度尺度;长度上限同时改变样本集合、长度压力与生成成本。
- 证据定位:Section 5.3–5.4,Figure 12–14,Appendix Figure 16–17;arXiv v3 HTML。
- 支持的最窄结论:长度分布会改变损失归约的回答总权重,并改变超长过滤所移除样本的语义组成。
- 解读:应对长度、优势符号、截断原因和重复行为做联合分层,避免直接按模型类型或最大长度选择组件。
结果 5:Lite PPO 的组合收益及统计补充
- 设置:Qwen3-4B/8B Base,Easy/Hard 数据;OpenReview 补充 Qwen3-8B-Base Hard 三随机种子和组件消融,另含 Llama3-8B 单设置。
- 适用版本:论文结论对应 arXiv v3;三随机种子、组件消融和 Llama3 数字对应 2026-08-25 读取的 OpenReview forum;代码核验对应 ROLL commit
5304da2f74e15429774511f1e67b2cc7ce136e65。 - Baseline:GRPO 与完整 DAPO。
- 指标:六项数学评测平均准确率及训练曲线。
- 结果:arXiv v3 单种子曲线中 Lite PPO 整体更稳;审稿补充的 Qwen3-8B-Base Hard 三种子均值为 49.44 ± 0.89,高于 DAPO 44.77 ± 0.33 和 GRPO 42.17 ± 0.35,作者回复未说明
±的统计口径。组件删除均降低单设置分数。 - 对照是否可比:相同模型和数据下的算法对照具有局部可比性;DAPO 动态采样改变 rollout 数,论文未报告实际生成 token、硬件时间与完整 baseline 配置,按 step 不能确认等计算量。
- 证据定位:Section 6,Figure 1、15;arXiv v3 HTML;OpenReview rebuttal 与 forum。
- 支持的最窄结论:混合归一化与 token 级归约在一个 Qwen3-8B-Base Hard 三随机种子设置和一个 Llama3-8B 单设置中优于所测 GRPO/DAPO 配置。
- 解读:该结果建立了一个简洁候选配方;跨任务、跨训练框架和对齐后模型仍需要同口径复验。
OpenReview / 审稿意见吸收
- Reviewer consensus: 4 份官方评审认可组件拆解的实践价值、统一实验框架和 Lite PPO 的简洁性;当前公开
rating/confidence为 8/4、4/4、6/3、6/3,最终决定为 ICLR 2026 Poster 接收。认证 API 在 2026-08-25 读取到 20 条可见 note,包括 submission、official reviews、rebuttal、meta-review、comments 和 decision。 - Main criticisms: 主要质疑集中于主体单随机种子、单一 Qwen 模型家族与数学领域、Lite PPO 缺少两组件联合消融、Base/对齐后解释存在长度和能力混杂、“scaling law”表述过强,以及训练轴、计算成本和配置复现信息不完整。
- Author response: 作者补充 Qwen3-8B-Base Hard 三随机种子和组件删除实验,一个 Llama3-8B 设置,数学训练后对 LiveCodeBench/GPQA/MMLU-Pro 的迁移评测,以及加入 Clip-Higher 的对齐后变体;作者同意把缩放律收窄为尺寸相关趋势。接受版 PDF 未收录多随机种子表,补充结果应继续按 forum 证据引用。
- 对可信度的影响: 三随机种子与组件删除结果提高了 Lite PPO 在一个主要设置中的可信度,Llama3 提供一个跨家族补充结果。任务覆盖、计算量对齐、完整因子消融和可执行配置仍未解决;审稿补充不能把局部结果提升为通用 RL4LLM 路线图。
主要启发
1. 强化学习组件应由其实际激活条件选择
DAPO/GRPO 等算法名把多项选择绑定在一起,本文 Section 5.1–5.4 的 Figure 5、Figure 7–14 显示这些组件效应与不同中间状态相关:裁剪触发率直接决定 Clip-Higher 是否改变目标,回答长度直接决定两种损失归约是否具有不同权重;Easy 数据的奖励标准差由约 0.47 降至约 0.22 时,标准差缩放与退化相关;8K 与 20K 下超长过滤移除的样本组成不同。组件选择由此可以从模型类别转为裁剪触发率、奖励方差、长度—优势联合分布和截断类型。
迁移到代码、工具使用或多轮智能体强化学习时,可分别实例化这些变量:统计动作或 token 的概率比越界率、按任务组的奖励方差、轨迹长度与优势相关性,以及达到交互上限的真实原因。若提高裁剪上界后触发集合不变、改变损失归约后分层梯度不变,或过滤后只减少有效成功轨迹,则相应技术选择应被否定。当前证据主要来自单轮数学 RLVR,过程奖励、连续奖励和异步策略滞后可能改变这些关系。
2. 归一化不变量可以定位实验与实现之间的缺失变量
v3 Appendix Figure 18 与已注释的 Section 5.1.1 声称,二元奖励由零一映射到正负一后会显著改变 z-score 归一化结果。在样本、mask、统计范围和代码路径相同时,该正仿射变换后的标准化优势在理论上保持不变;完整训练仍含随机动态。论文图中的大幅差异无法由奖励编码范围本身解释,可能来自未披露实现耦合、图例配置或运行方差。这个矛盾提供了一个必须满足的代数契约,也保留了多种待核验来源。
这一判断可迁移到任何包含归一化、中心化或比例缩放的训练系统:先列出目标函数在重参数化下应保持的性质,再用等价输入执行成对测试。若等价变换显著改变梯度、更新后参数或学习曲线,应检查 epsilon、统计范围、mask、跨设备聚合、精度与代码分支。该诊断在包含裁剪、离散化或非线性奖励变换时可能失效,需要先确认不变量的成立条件。
局限
- arXiv v3 主体实验使用
seed=42;曲线阴影来自 11 step 时间窗平滑及窗口标准差,不能解释为跨随机种子不确定性。OpenReview 只为一个 Qwen3-8B-Base Hard 设置补充三随机种子。 - 所有主体结果集中于 Qwen3 4B/8B 与六项数学评测。Llama3 只有一个回复表格,领域外实验只评测数学训练后的最终策略,没有在非数学训练中重新选择组件。
- Easy、Medium、Hard 数据来自不同数据源和采样过程,难度与领域、题型、质量共同变化;Easy 数据包含 MATH-500 level 1,论文未披露与 MATH-500 评测集的去重。
- 奖励范围实验报告的归因与标准化的正仿射不变性冲突,v3 又同时存在正文注释、引言
§??与附录残留,原因未查明。 - Figure 5 对优势均值的统计范围表述不一致,正文写 batch mean,公式和图示可读为同 prompt 均值;
std的自由度、跨设备聚合与 mask 顺序也未固定在论文配置中。 - 论文以奖励标准差与准确率曲线推断梯度放大,没有报告梯度范数、更新范数、KL 或梯度爆炸事件,归一化机制仍含未验证因果环节。
- Clip-Higher 的语言学解释来自一个案例和 top-20 频率,没有推理路径新颖性、连接词因果贡献或人工质量评测;“scaling law”只由两个尺寸和四个取值支持。
- Base/对齐后比较同时改变 SFT/对齐过程、初始能力、策略熵、响应长度和 token 分布;模型标签不能单独识别组件效应的因果来源。
- 损失归约实验未执行长度匹配、长度—优势分层或梯度尺度控制;论文对“保持结构一致性”的解释缺少直接结构指标。
- 超长过滤实验把生成上限、被过滤样本比例、有效训练 batch 和 rollout 成本一起改变;重复率是超长样本内的条件比例,缺少分母、EOS 校准和有效长推理标注。
- Lite PPO 的 arXiv v3 结果没有完整
组件因子消融、最终数值表、checkpoint 规则或等生成 token 比较;DAPO 动态采样使 step 数与计算量不等价。 - 附录声明
max_steps=500,多条主图曲线延伸到约 800–2000 step;正文最大回答长度为 8192,附录为 8000。论文未报告硬件、GPU·小时、实际生成 token、规则验证器版本和完整 baseline 配置。 - 当前 ROLL 文档示例与论文的 128×8、8K、REINFORCE、无 KL、无 critic、token 级归约不一致,仓库也没有论文专用 Lite PPO 配置;公开代码能支持组件实现,尚不能直接复现整组报告结果。
True/False清理与“正确答案后无停止重复”说明规则奖励含噪声;具体过滤规则、删除数量、过程正确性评测和去污染信息未披露。
跨论文关系
- 与已有论文的作者或机构关系:本文与 Qwen3 共享 Bo Zheng,并使用 Qwen3 Base 与对齐后检查点;与 ROLL/RollArt 系统线共享 Weixun Wang、Shaopan Xiong、Ju Huang、Siran Yang、Jiamang Wang、Wenbo Su 和 Bo Zheng 等作者;Jian Hu 连接 OpenRLHF、REINFORCE++、ProRL 与 BroRL。
- 与已有论文的主题关系:熵机制分析 将探索收益连接到基础策略已有路径与熵消耗,本文在 Qwen3 对齐后设置中补充 Clip-Higher、裁剪率与熵曲线的局部证据;RLVR 推理边界研究 说明准确率改善不能单独证明扩展基础模型的能力边界,本文没有报告大采样预算下的
pass@k或 solved-set overlap。 - 与已有论文的方法关系:DAPO 是最直接的组件来源与完整基线;本文在 Qwen3 4B/8B 上重新检查组内归一化、Clip-Higher、token 级聚合和超长过滤,把其外部有效性限定到初始化、奖励方差和长度条件。Lite PPO 延续 GRPO/DAPO 的 PPO 裁剪代理目标,不训练价值模型,只保留混合归一化与 token 级归约。该结果与 DAPO 原始 Qwen2.5-32B、16 条 rollout、约 20K 长度和 AIME 设置不同,不构成同条件反证。