阅读笔记
Towards a Statistical Understanding of Mixture of Experts
本文把 MoE 的预测误差分解为局部组合的逼近误差、专家学习误差和路由估计代价,在专家误差受控及路由正则条件下建立风险上界,为分析稀疏激活、路由几何和共享分解何时有益提供了条件性框架。
所读版本 arXiv v1 HTML,对应 v1 PDF,共 166 页。
论文脉络
贡献与方法总览
本文要解释的问题是:给模型更多专家之后,什么条件能让新增容量转化为更好的预测?论文把 MoE 看成输入相关的局部组合。专家提供候选函数,路由决定在某个输入上怎样组合它们;有限样本还要同时支撑专家拟合和路由选择。因此,分析 MoE 需要分开考察“函数能否表示目标”“专家学得怎样”和“路由能否从数据中选好组合”。首要贡献是把这些因素放进同一个统计风险上界。
为建立这个上界,论文先固定用于比较的总体专家,再允许训练中的专家随过去数据更新;离散出一组固定路由候选,预热专家并校准预测尺度,随后依据新样本的预测似然更新候选之间的聚合权重。在线预测经过时间平均,再投影到一个候选路由上,输出由该路由和时间平均专家组成的预测函数。证明将它的误差联系到最佳局部组合、专家相对总体基准的误差,以及有限样本选择路由的代价。总体专家只是比较基准;路由候选内部选择专家的权重,与候选之间根据数据更新的聚合权重,属于两个不同层级。
稀疏路由延续这一论证,但要额外处理专家集合突然切换:将输入分成选择集合稳定和接近切换边界的部分,控制后者的概率质量,再建立风险上界。论文还用局部优势区域说明激活数和路由几何的作用,并比较线性、二次与核门控。共享专家部分另行固定区域与局部学习规则,研究公共成分被共享部分承担之后,残差是否更适合局部学习器;低维模拟提供相应现象的证据。
这几部分分别回答表达、估计与学习规则匹配的问题,假设不能直接合并:表达构造允许重新设计专家,风险界要求专家误差受控,共享比较固定特定学习程序。它们提供解释 MoE 的条件性框架;实际端到端神经网络训练能否满足条件,仍需另外核验。下文先走通核心机制,再检查这些结论得到了多强的支持。
输入相关选择让简单专家形成局部表达能力
如果所有专家都输出常数,固定权重的组合仍是常数。允许权重随输入变化,就能在不同区域选用不同常数,形成分段预测。新增表达能力可以来自选择方式本身。
论文给出一个具体构造:在输入域上放置规则网格,每个中心保存目标函数在此处的值;路由选择离输入最近的中心。将每个中心复制成固定数量的相同专家,便能让固定激活数的 Top-K 实现这个近邻选择。网格不断变细时,连续目标在相邻位置的函数值越来越接近,预测误差随之缩小。一个对应示意是:用若干常数台阶逼近一条连续曲线,提高分辨率需要增加台阶和专家总数,每次查询仍只激活固定数量的专家。局部构造及证明
这个结果建立了表达的可能性,也指出总容量与单次激活量可以分开变化。构造允许按目标重新安排专家,没有说明训练会找到这些专家;固定专家库中直接减少激活数,也未必保持同样误差。该构造还使用重复得分,后续稀疏风险界的得分斜率分离条件需要另行满足。
风险上界把表达、专家拟合和路由估计分开
论文的预测对象是紧输入域上的标量回归函数。共享函数始终相加,路由函数通过非负且和为一的输入相关权重组合;这里的专家是预测函数,未指定为某种 FFN,也未描述多层 Transformer 的隐藏状态演化。
为区分“已经能表示”与“从有限数据学到”,作者构造以下学习过程:
- 将有界路由参数空间离散成有限候选,依次划分预热、尺度校准和聚合三个数据块。专家每次只用过去样本形成当前预测。
- 预热专家后,在校准块上计算各候选的一步预测残差,用残差平方均值估计预测尺度,并截断到已知区间。
- 聚合块中,各候选从相同先验权重开始。新标签到达后,按预测密度乘上旧权重并归一化,随后才更新专家。每个候选自身的路由参数保持固定,变化的是候选之间的权重。
- 对在线聚合预测做时间平均,选择在总体平方距离上最接近它的候选路由。最终预测使用该路由与同一时段平均后的专家函数。
专家可以按自己的规则继续学习,包括使用过去聚合结果;定理把其相对总体专家的误差序列作为已给定条件。因而该过程能够分析带有更新专家的预测,专家训练本身的有效性仍由条件承担。学习过程的定义
核心上界用来回答最终误差由哪些因素控制:
第一项是在规定路由类中、用总体专家能达到的最佳平方逼近误差;第二项来自训练专家偏离总体基准,两个平均量分别对应校准与聚合数据块;最后一项是有限样本选择路由的估计代价。
证明的关键连接是:序贯似然聚合使累计密度损失接近一个固定候选,额外代价由候选数量的对数控制;再把密度差异转换成回归风险,用专家误差条件替换训练中的专家,并用路由连续性控制参数离散误差;时间平均和投影得到最终函数的保证。校准环节使噪声尺度进入这个密度比较,数据先预测后更新的顺序保证当前标签没有提前参与当前预测。风险分解的证明
稀疏选择需要控制切换边界
Top-K 路由的特殊困难是:得分发生很小变化,也可能替换一个正在使用的专家。如果两个专家的输出差异较大,这种替换会导致预测跳变。
论文把输入分为两部分。激活集合不变时,可以用权重随参数变化的连续性控制误差;激活集合发生变化时,输入必然接近某对得分相等的边界。假设输入很少集中在这些边界附近,并让不同线性得分的斜率保持一定分离,就可以控制切换区域的概率质量,延续前面的有限候选聚合论证。切换区域的控制方法
因此,“最大可能跳变很大”与“总体平均误差仍可控制”可以同时成立。稀疏风险界保留前面的三项结构,路由学习代价增加一个由斜率分离尺度决定的对数项;较少激活专家并没有把上界中的专家总数直接替换成激活数。具体条件与上界的用途在证据章检验。稀疏路由的风险上界
激活数与路由几何取决于局部组合的需要
给定专家库时,某个区域若已有强专家,选择一个专家可能足够;如果多个专家的混合在该区域更好,单专家选择就会有表达缺口。一个示意是目标为零、两个固定专家分别输出负一和正一:等权混合可以精确预测,任意单专家都有误差。允许训练一个直接输出零的新专家后,比较对象已经变化。区域单专家与混合的条件性比较
路由还需要能表达专家的优势区域。固定输入坐标与专家身份时,两个线性得分之差只能产生直线边界;内圆与外环的专家分配需要更合适的几何表达,二次得分可以利用半径平方实现。高斯核门控通过网格中心处的专家权重插值,进一步适配规则区域,但细网格会增加参数和估计成本。论文也给出候选路由类之间的选择保证,其前提是每个候选已经拥有相应类内风险界。路由几何与选择的分析
这些结果支持从“当地需要什么组合、路由能否表示、估计成本是否可承担”三个角度选择路由。局部混合优势在相应命题中是明确假设;输入表示可以继续学习时,原来固定坐标的几何限制也需要重新检查。
共享分解改变局部学习器面对的目标
共享专家部分研究公共函数加区域残差的目标。其关键问题是:把公共成分交给共享学习规则后,剩余目标是否更适合局部规则?“公共”描述跨区域共享的结构,公共函数本身既可以简单,也可以复杂。
具体例子由线性公共趋势与固定阶周期 Fourier 残差组成。共享联合模型同时拟合公共线性项和局部周期系数;纯路由 Fourier 学习器需要独自拟合每个完整分支。非周期线性斜坡用周期基函数展开时,会留下缓慢衰减的尾部误差,所以纯路由学习器要用更多系数换取较小偏差,并承担更大的估计方差。
这个例子把差异定位到学习规则与目标的匹配关系。给纯路由分支也加入线性函数,就可以消除相应逼近障碍。因此,论文建立的共享收益带有学习程序限定;在函数能力对齐之后,参数共享本身还有多少独立收益,需要另外的对照。共享比较与具体例子
证据与结论
风险定理支持条件性分解,训练与系统收益仍有独立前提
稠密与稀疏结果都把预测风险上界分成逼近、专家轨迹误差与路由估计代价,这直接支持论文的首要贡献。稀疏版本需要输入分布在宽度为
关键限制是专家误差受控属于假设,论文没有导出联合 SGD 的训练动力学。候选网格可能很大,最终投影使用通常未知的输入总体分布;多个 Top-K 候选的聚合也可能覆盖全部专家,时间平均专家的执行成本没有统一计入。于是,这些结果可以解释不同误差来源及稀疏切换的统计代价,实际训练可行性与推理加速需要各自的证据。学习构造与可实施性说明
同时,上界中随专家数增长的项没有证明实际误差必然增长,也没有建立对应 minimax 最优性。单个候选表示可以减少专家求值次数,整个理论学习过程的墙钟时间仍未得到保证。
路由模拟支持指定配置中的几何匹配
作者在三个固定且已知的专家、二维均匀输入下比较线性、二次和高斯核门控,每个配置重复 100 次。下表摘录每种生成过程的较大样本设置:与生成几何匹配的门控类取得较小误差。指标是各观测输入上估计门控向量与真实向量的平方欧氏距离均值,括号为 Monte Carlo 标准差。原始结果表
| 数据生成过程与样本数 | 线性门控 | 二次门控 | 高斯核门控 |
|---|---|---|---|
| 线性,400 | 0.004(0.002) | 0.013(0.007) | 0.020(0.009) |
| 二次,400 | 0.027(0.006) | 0.013(0.013) | 0.018(0.006) |
| 非线性,1000 | 0.322(0.025) | 0.339(0.025) | 0.266(0.014) |
固定专家让比较集中到路由估计;各类参数搜索网格不同,二次生成设置的网格围绕真实规格设计,核中心数与带宽也随设计变化。附录按观测输入定义误差,没有注明独立测试输入。因此结果支持该低维、已知专家协议中的几何匹配现象,尚未识别统一搜索预算下的普遍优势,也不能作为语言模型预测损失的比较。模拟设置与指标
共享专家的速率差异来自指定学习器的逼近障碍
在线性公共趋势与固定阶 Fourier 残差的两区域例子中,共享联合模型有
这个证据具有判别性:它明确展示了去除公共成分怎样改变局部拟合难度,也明确指出改变纯路由的基函数可以消除障碍。下界针对指定学习器,不能推广为全部纯路由算法的下界。一般共享比较中的联合估计上界本身进入了假设,附录另给出满足加法复杂度条件的联合最小二乘路径;顺序拟合公共函数再拟合残差还需要额外条件,避免先吸收局部信号。共享学习规则的条件
由此可以接受“匹配公共结构和局部学习规则的分解能改善特定学习程序的统计效率”;参数共享相对函数能力与预算均对齐的独立学习器有多少收益,现有结果尚未单独识别。
共享模拟显示有限样本改善,比较同时改变了函数类
下图比较样本数为 200、400、800、1600 的设置,每个设置重复 200 次。高斯噪声标准差为 0.5,真实区域阈值为二分之一;两种方法都在
两组设置中共享模型的误差均较低。第一组共享配置增加线性公共项,两种配置的局部 Fourier 阶数固定为三;第二组局部专家为线性函数,共享配置增加三阶 Fourier 公共项。对照改变了可用函数类,未匹配参数与计算,也没有让纯路由 Fourier 阶数随样本最优增长。因此,曲线验证了匹配公共结构带来的有限样本改善,未直接验证前述最优截断下的渐近速率差。共享模型的原始曲线
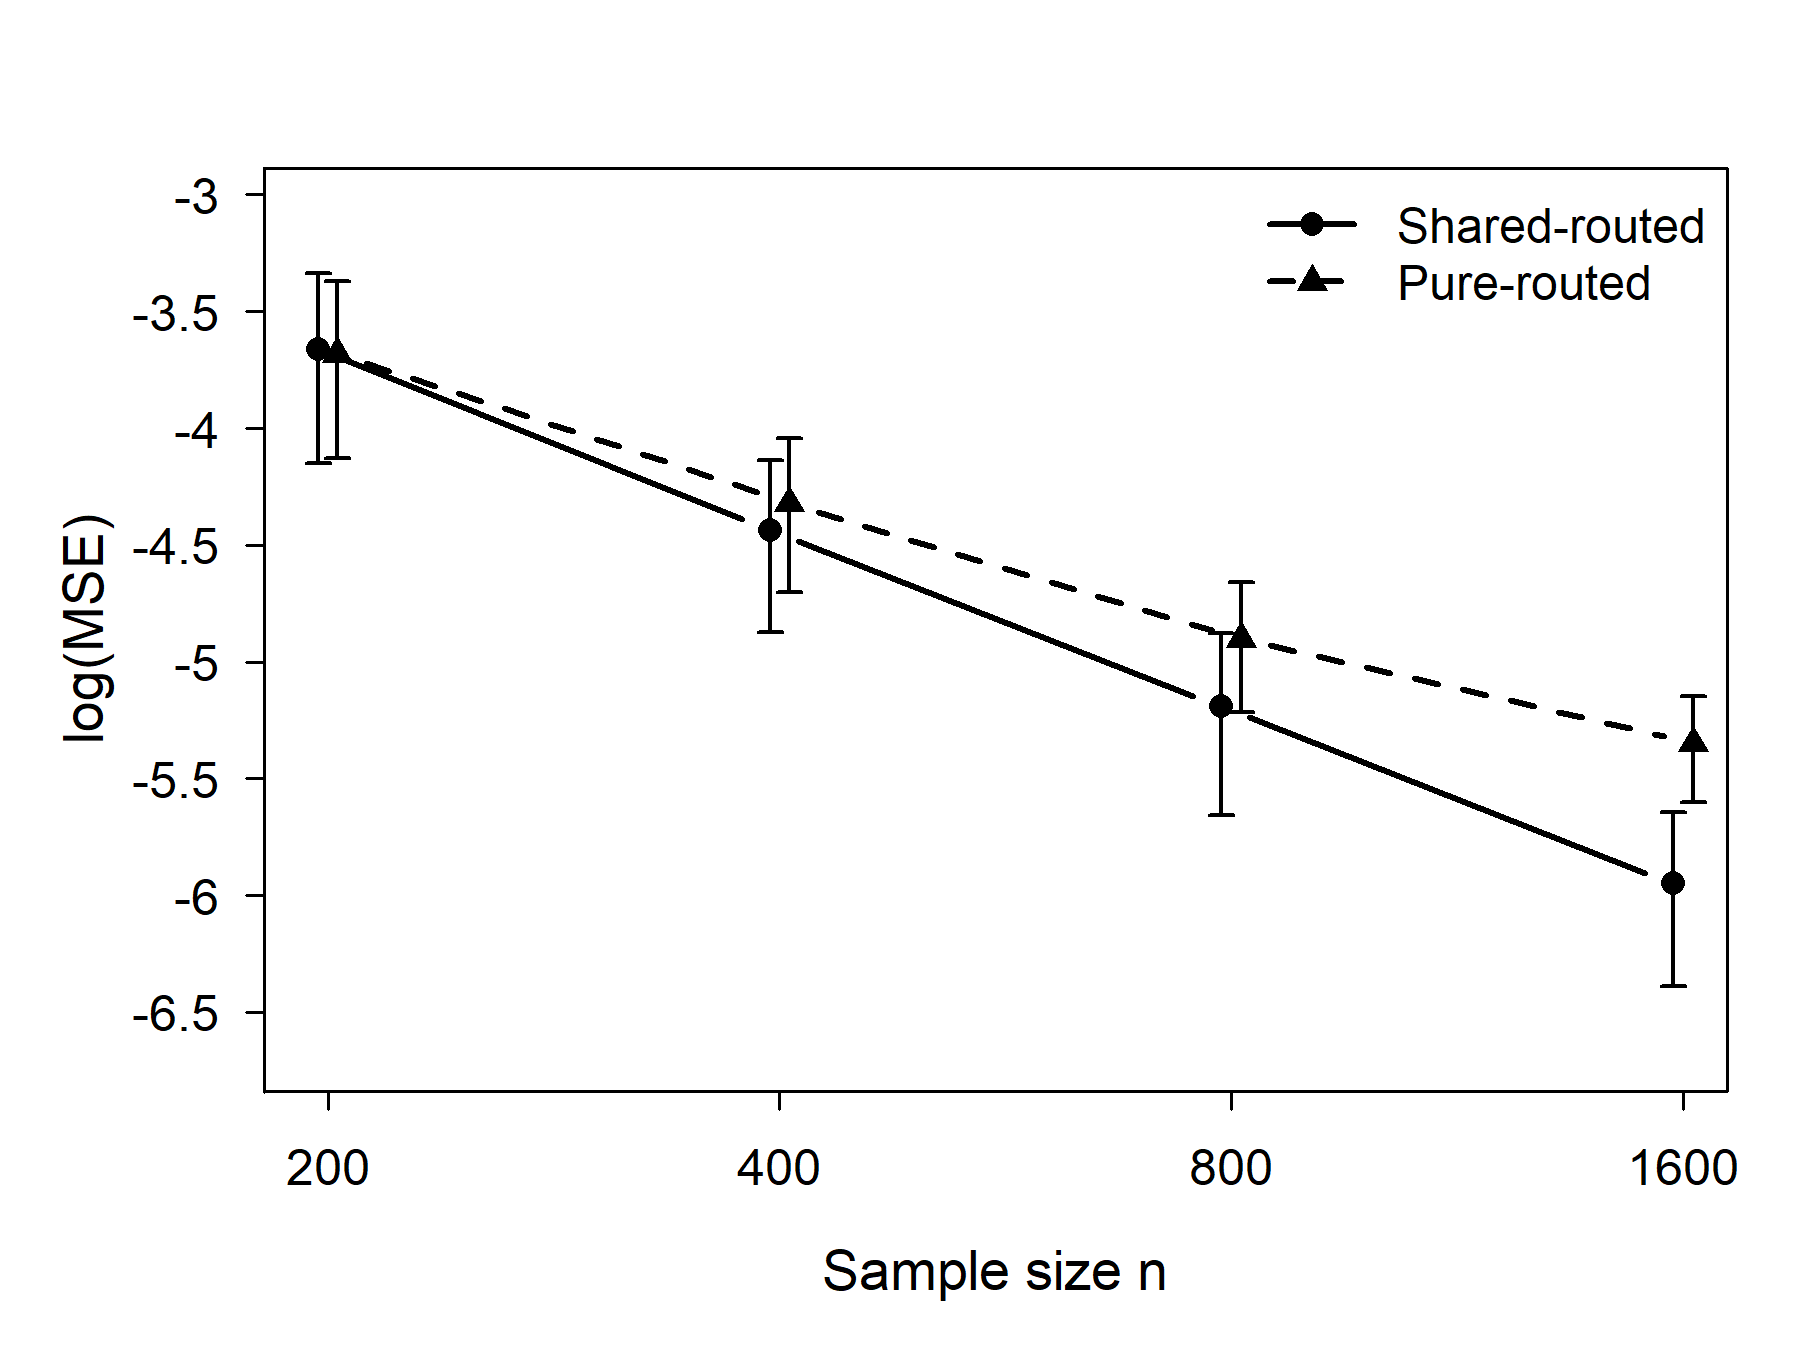

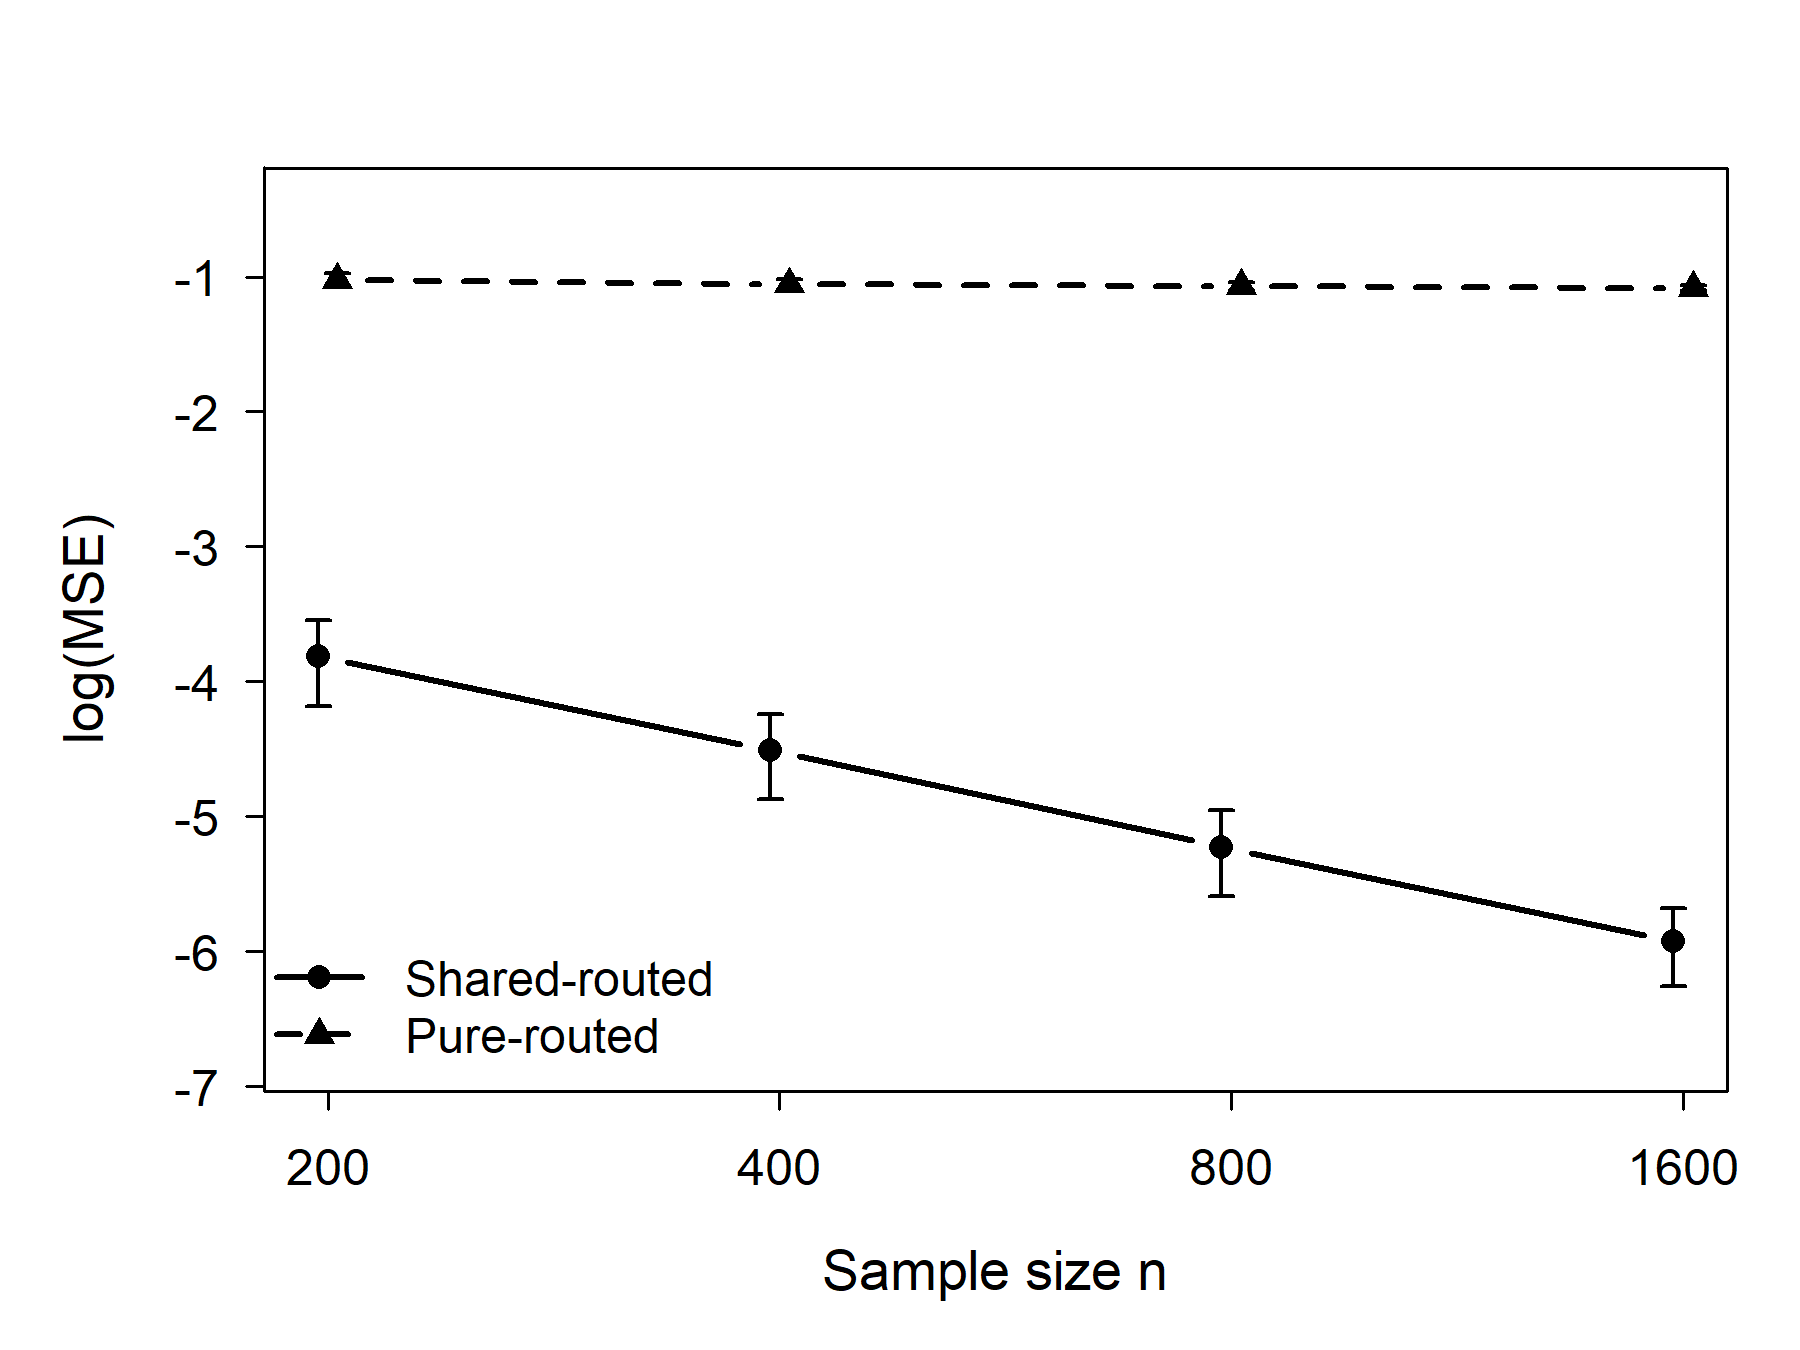

作者未提供曲线逐点数值表,本笔记保留图像而不从像素反推精确数值;本次没有独立复现这些模拟。
抽象与迁移
单次调用成本与从数据中选择组合的难度需要分别评估
本文增加了一个可复用的区分:限制每次实际使用多少组件,只控制条件计算的一部分;从整个候选集合中学习输入相关选择,还有自己的统计问题。这里的直接依据是稀疏风险上界仍包含专家总数,并需要控制选择边界。它提醒我们分别分析逼近收益、专家拟合和路由估计;该上界未证明每一种实际学习器都必须承担相同代价。
迁移到预算固定的工具选择系统时,工具库对应专家库,单次允许调用的工具数对应激活数,选择器对应路由。一个待验证预测是:新增工具高度重叠、缺少独立任务优势时,工具库扩充可能增加选择困难;改善选择训练或提供更可区分的工具描述,可能比继续扩库更有效。检验应固定调用预算和工具本身质量,同时测量选择泛化与端到端任务收益。
这个迁移需要额外核验:工具往往有离散副作用和多步依赖,无法直接视为标量回归函数。如果工具选择只靠固定规则、没有从有限数据估计选择器,本文的统计学习论证也不能直接套用。现阶段保留为实验假设。
共享收益应区分结构复用与表达能力变化
共享专家例子揭示了一个具体机制:把某类成分交给更适合它的学习规则,会改变剩余学习问题的难度。这个判断有基函数失配、尾部误差和速率比较的直接支持;公共成分的复杂程度本身不足以决定是否值得共享。给纯路由分支加入线性函数即可消除所展示障碍,提供了判断这一机制的条件变化。
迁移到多任务共享模块时,先明确公共成分、局部残差与各分支可表达的函数,再区分两个待检验问题:新增模块是否补入原模型缺少的能力,同一种能力跨任务共享参数是否进一步改善估计。可以让独立分支也获得相同函数类型,并报告容量、计算与样本口径,观察原有差距如何变化。
若补齐函数能力后差距明显缩小,就支持表达匹配解释;若进一步对齐相关预算后仍有稳定差异,可以继续检验跨任务样本复用等原因,不能仅据剩余差异确定因果机制。任务之间缺少公共成分、共享限制妨碍必要差异,或优化过程无法得到相应分解时,该迁移判断需要重新审查。
Source
- Workflow version: v3
- Material type: research-paper
- Analysis modules: theory, experiment
- Canonical source: https://arxiv.org/abs/2609.03501
- Title: Towards a Statistical Understanding of Mixture-of-Experts
- Authors: Siyuan He, Bokai Yang, Jie Hu, Ziwen Gao, Yuhong Yang
- Published / updated: 2026-09-03,arXiv v1 首次公开。
- Version / revision read: arXiv v1 HTML,对应 v1 PDF,共 166 页。
- Accessed: 2026-09-05
- Reading scope: 本笔记累计读取正文 Sections 1–7、附录 A–E、F.2 和 G.1–G.2;重点核对局部构造、两类路由风险界、共享比较的学习规则及模拟协议,查看两张共享专家原图。此次修订依据同一 v1 重组机制、证据判断和迁移分析。未展开 F.1 的 ERM 证明和 F.3 的稠密路由专门化界,未逐式独立复证全部附录,也未复现模拟;未进行公开审稿、代码或外部作者档案检索。
- Key figure decision: include
- Key figure rationale: Figure 1 的两个子图显示,在不同的共享与局部函数配置中,共享结构与局部学习规则的匹配会改变误差随样本量的变化,适合与附录中的固定基函数条件一起解读。
- Review status: page-type=not-checked; match-confidence=not-applicable; observed-at=2026-09-05; venue-status=unknown
作者与关系
按 v1 作者块顺序记录论文时机构及明确标记:
| 作者 | 论文时机构 | 论文明确角色 |
|---|---|---|
| Siyuan He | 清华大学求真书院 | 共同第一作者 |
| Bokai Yang | 清华大学求真书院 | 共同第一作者 |
| Jie Hu | 清华大学丘成桐数学科学中心 | 未标注额外角色 |
| Ziwen Gao | 华东师范大学统计学院、KLATASDS-MOE | 未标注额外角色 |
| Yuhong Yang | 清华大学丘成桐数学科学中心、北京雁栖湖应用数学研究院(BIMSA) | 通讯作者 |
本地作者数据的姓名和别名检查未匹配到这五位作者的既有 profile,因此仅保留作者块信息。共同机构与通讯标记不足以推断具体师生关系,本次未扩充作者档案。
跨论文关系
- 与 DeepSeekMoE:本文以其共享专家与局部专门化设计为动机。本文补充的是在固定学习规则下,共享公共函数如何改变局部拟合目标的统计解释;它没有验证 DeepSeekMoE 的真实神经网络训练一定实现该分解,也没有替代细粒度专家的预算对齐实验。
- 与 Kimi K3:本文的后续展望引用 K3 讨论专门化与负载控制的张力,将系统约束下的路由设计列为后续方向。因此 K3 提供架构动机,本文的风险定理尚未覆盖其负载控制、潜空间专家或深层模型训练。
- 与 SMELT:这是基于本站笔记的本地比较,不声明引用依赖。SMELT 在近似匹配 FLOPs、参数和 KV cache 的条件下研究循环 MoE 的经验缩放;本文分解给定专家学习条件下的统计风险。两者分别提供预算约束下的模型实验与函数层面的条件性解释,不能用后者直接解释前者的循环收益。
技术补充
风险界的条件与可实施性
稠密与稀疏主结果使用独立同分布样本,噪声独立于输入,标准化噪声密度已知、尺度位于已知正区间,并满足有限四阶矩及位置—尺度扰动的 KL 正则性。目标、总体专家和训练专家一致有界;共享专家数固定,路由专家总数可以随样本数增长。稠密线性路由的参数盒半径按专家数的对数增长。基础设定
稀疏斜率分离尺度若只按专家数的多项式缩小,新增学习项维持对数规模;更快缩小时不能直接忽略。移动跳变边界的 Top-K 类可以有无限的一致范数覆盖数,这与在分布意义下控制风险使用不同度量。稀疏类的复杂度
固定专家数时,作者另提出用独立输入样本将在线聚合门控作为软标签、通过交叉熵投影到线性 softmax 的凸问题。函数风险保证还需要门控差异经过专家加权后不能全部抵消的兼容条件;网格聚合成本依然存在。负载均衡、容量、通信与硬件时延未纳入主风险分析。经验投影的附加条件
v1 稠密定理声明的参数网格精度为
表达构造、几何逼近与类选择的边界
近邻构造使用线性得分
原文还用 sigmoid 专家乘以相同门控得到 sigmoid 的平方,并通过复平面极点阶数区分其与有限全局线性组合的精确表示能力。这个结果不直接排除后者对该函数的任意精度逼近。非线性专家的表示例子
高斯核门控在规则分区、连续输入密度与边界层正则条件下得到全域门控平方误差上界
路由类选择先在构造数据上分别训练候选,再用独立数据校准、按似然聚合,时间平均后投影回候选列表。在每个候选已有类内风险界时,选择增加
共享部分以外,论文还给出提取振荡公共函数前后的局部仿射逼近上界。两者都是构造上界,没有对应匹配下界,振荡频率的四次因子不能直接解释成已证明的实际误差改善倍数。公共结构的另一种例子