阅读笔记
DeepSeek V4.1 Flash: Pushing the Limits of KV Cache Compression
DeepSeek-V4.1-Flash 将因果编码器与解码器分工、跨层稀疏 KV 复用、四位全局缓存和近似窗口重放组合起来,把长输入的预填充主干计算近似减半、全局 KV 降至每 token 890 字节,并在发布方评测中显著提升多项 agent 能力;端到端服务收益和近似重放的极端条件可靠性仍缺少充分公开验证。
所读版本 Hugging Face revision fb2764a5cf321eaa5070ca8f9e892818f477c16d;固定 PDF、同 revision 的模型卡、配置、评测说明和参考推理代码。PDF 共 51 页,SHA 256 为 ba68e2e40408125ae6d2f63a9a241b61c73910691c74ec1a2a7023c851eac08d。
论文脉络
贡献与方法总览
长时程 agent 会反复读取工具输出、代码、文档与历史交互。处理这些输入要付出三种不同成本:新输入与未命中前缀的预填充(prefill)计算,正在服务的请求在 GPU 高带宽显存(HBM)中保留的 KV,以及为后续前缀复用而长期保留在 SSD 或主机内存中的状态。DeepSeek-V4 已经降低了长上下文注意力计算,V4.1 进一步把缓存容量、搬运和恢复计算作为联合设计对象。首要贡献是让一个更大的多模态 MoE,在保留逐层局部处理的同时,用很少的全局状态支撑百万 token 上下文。问题与设计目标,§1,pp.4–6
完整执行链是:图像经视觉编码器和投影器转成视觉 embedding,与文本进入一个 40 层主干;前 20 层因果编码器处理输入,产生自身的压缩全局 KV,并由最后一层输出构造后 20 层解码器共享的全局 KV。解码器因而可以跳过大部分输入位置的完整计算,只为最近 128 个位置重建逐层滑动窗口状态。生成新 token 时,编码器和解码器都参与计算;每层用自己的 query 读取本层局部 KV 和跨层共享的全局 KV,再经过 MoE 更新表示,最终输出下一个文本 token 的分布。总体结构与 CED,§2.1–2.2,pp.7–9
这条路径还包含三个相互配合的改变。CSA2 将“生成 KV”“重新选择位置”“复用已选位置”分开安排,使全局 KV 只在少量层生成。主 KV 与索引器缓存使用不同的四位格式降低字节数。SWA Bounded Replay 接受窗口状态的近似恢复,使局部 KV 可以采用短期缓存,减少持久存储。Engram、Single-Pass mHC 和 DSpark 分别补充条件记忆容量、降低残差读写、加速草稿生成与验证;多模态预训练、任务环境生产、RL 与多教师 OPD 则形成最终模型能力。架构、缓存和训练概述,pp.7–20、25–32
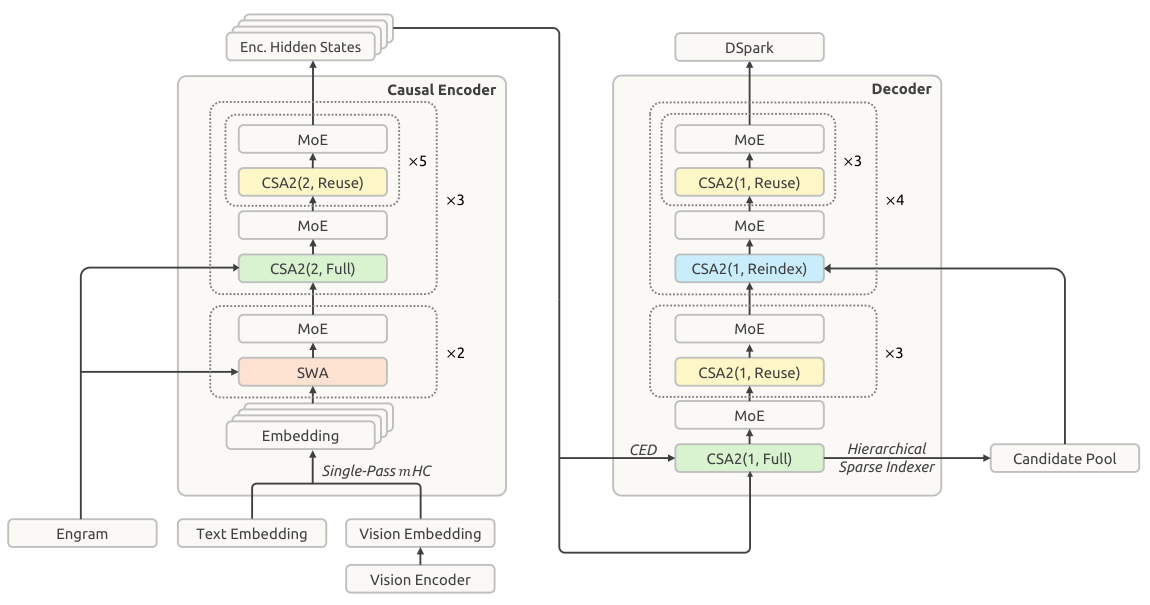
CED:让解码器的全局历史由编码器一次提供
普通逐层注意力需要从每层自己的 hidden state 生成历史 KV,因此要建立高层 KV,就必须计算输入在所有低层和高层的表示。因果编码器—解码器(Causal Encoder-Decoder,CED)把这条依赖改为:解码器的全局 KV 来自编码器最终输出;解码器本层只需提供随深度变化的 query,以及本层局部窗口 KV。
用
局部窗口是提前结束 prefill 的剩余依赖。 解码器每层的 SWA KV 来自本层表示,无法仅由编码器输出直接替代。作者保留这条较深的局部处理路径,再用最近
例如,示意输入含 100,000 个 token,按上述计数,比例为
这一设计明确继承了 YOCO 的“下半部生成共享历史,上半部按自身 query 读取”的依赖分解。YOCO 的上半部主要使用共享全局交叉注意力,支持提前退出 prefill;CED 在上半部保留逐层 SWA,增加局部 KV 的生成深度,同时引入重放问题。这个差异解释了 V4.1 为什么需要架构和缓存恢复联合设计。YOCO §2.1–2.3、本报告 §2.2
CSA2:共享存储、刷新选择和逐层计算分别控制
CSA2 的主 KV(Main KV)缓存由供所有 query heads 共享的 latent 条目组成,覆盖全局历史位置;Selected Main KV 是某层按选中位置读取的主 KV 子集。索引器使用索引器 query 与索引器 K 为位置打分,主注意力再使用本层主 query、选中的全局条目与本层 SWA KV 计算输出。三种模式是静态分配的,每层都有自己的主 query 与局部 KV:
| 模式 | 主 KV 与索引器 K | 全局位置选择 | 保留下来的逐层能力 |
|---|---|---|---|
| Full | 当前源层生成 | 当前索引器选择 Top-512 | 新全局表示、新选择、新 query 和局部状态 |
| Reindex | 复用最近的 Full 源层 | 使用本层索引器 query 重新选择 Top-512 | 同一组历史表示上的新检索 |
| Reuse | 复用最近的 Full 源层的主 KV | 复用最近一次 Full / Reindex 的选择 | 本层主 query 重新计算注意力,本层局部状态继续更新 |
Full 表示具备完整的 CSA2 组件;其主注意力仍然是稀疏选择。Reuse 复用的是 KV 和位置集合,注意力输出仍随本层 query 改变。由此,状态共享不要求所有层进行相同的计算,重新检索也不要求重新保存一份历史。 三种模式与数据路径,§2.3.1,pp.10–11
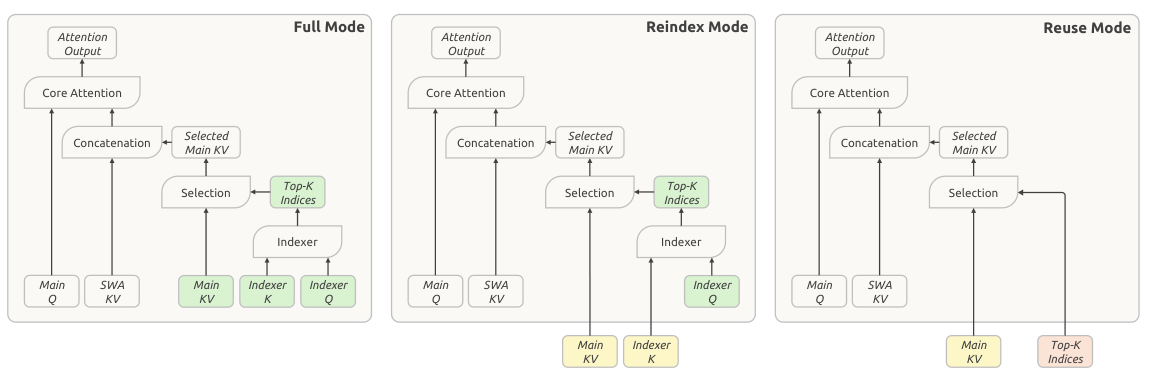
Figure 4 的颜色说明各组件由本层生成还是从前层复用。沿 Reindex 面板读取:底部黄色 Main KV 是共享的全局缓存,黄色 Indexer K 与本层绿色 Indexer Q 一起产生新的 Top-K Indices;Selection 按这些位置从共享 Main KV 取得本层的 Selected Main KV,再与 SWA KV 拼接交给 Core Attention。Reuse 面板则输入共享 Main KV 和已有 Top-K Indices,直接按位置取出条目。Figure 4 说明 KV 与索引的生成、复用和读取关系;Figure 5 在此基础上进一步限制解码器索引器的搜索范围。 Reindex 的基本定义是对共享 KV 重新选择,候选池是解码器额外采用的分层索引机制。Figure 4–5 与 §2.3.1–2.3.2,pp.10–12
按代码的零起始层号,具体安排如下:
| 位置 | 全局 KV 压缩率 | 模式安排 |
|---|---|---|
| 编码器 0–1 层 | 无全局分支 | 纯 SWA |
| 编码器 2–19 层 | 每 2 个 token 形成 1 个全局条目 | 2、8、14 层为 Full,每个 Full 后接 5 个 Reuse |
| 解码器 20–39 层 | 每 token 1 个全局条目 | 20 层为 Full;24、28、32、36 层为 Reindex;其余为 Reuse |
因此,38 层含全局注意力,4 个源层分别生成并保存全局 KV,其余层复用相应源层的缓存;8 层执行索引,30 层复用索引。CSA2 还去掉了 V4 压缩器的重叠窗口及绝对位置 embedding,索引器 K 直接由主 KV 投影得到,减少一条单独的压缩路径。配置,§4.2.1,p.22、固定版推理配置
解码器的分层稀疏索引器进一步减少后续 Reindex 的候选数。第 20 层先对所有因果可见位置打分,再从同一份全局分数产生两项选择:一项直接选出 Top-512,供本层主注意力使用;另一项以每块的最高位置分数为块分数,选择最多 2,048 个块,将块内全部位置纳入共享候选池。每块包含 8 个独立的 KV 位置,因此候选池最多包含 16,384 个位置。两项选择在逻辑上独立,选块直接使用全局位置分数。这个候选限制在后训练与推理中一致启用。分层索引,§2.3.2、Figure 5,pp.11–12
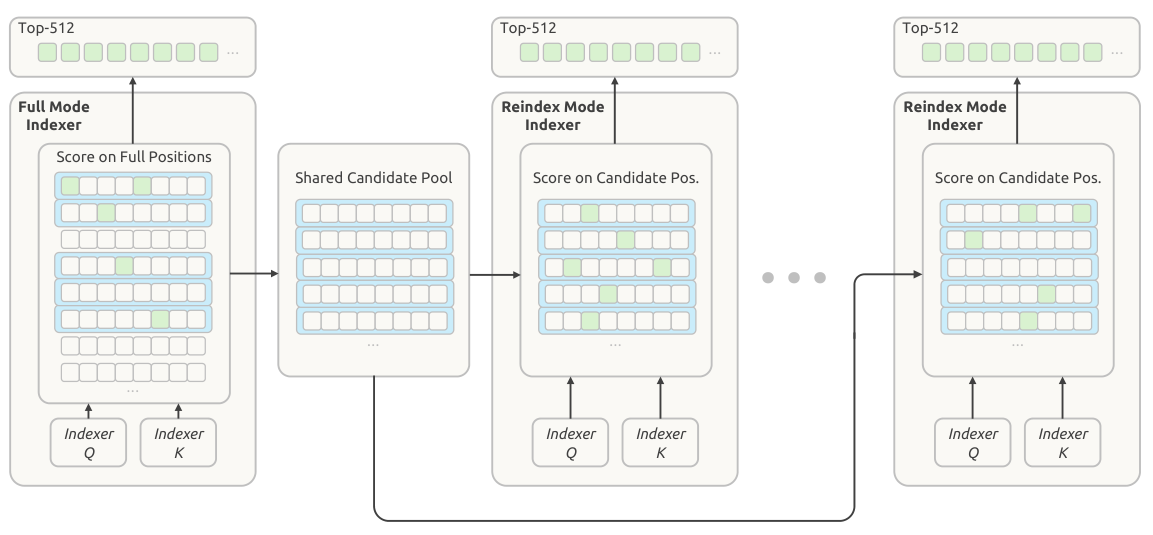
Figure 4 已经展示 Selection 之后的 Selected Main KV;Figure 5 进一步展示生成 Top-K 索引时采用的共享候选池。蓝框内的全部位置都进入候选池,包括当前层尚未选中的白色小格;后续 Reindex 层可以将这些位置选入自己的 Top-512,再读取对应的 Selected Main KV。
索引器的搜索范围与主注意力读取范围需要分开。 下表描述启用分层索引的解码器路径:
| 解码器层类型 | 索引器搜索范围 | 主注意力读取的全局 KV |
|---|---|---|
| Full | 全部因果可见位置 | 本层选出的最多 512 个位置对应的 Selected Main KV |
| Reindex | 共享候选池,最多 16,384 个位置 | 本层用自己的索引器 query 重新选出的最多 512 个位置对应的 Selected Main KV |
| Reuse | 沿用最近一次 Full / Reindex 的位置选择 | 最近一次选出的最多 512 个位置对应的 Selected Main KV |
三种模式的主注意力还同时读取本层 SWA 局部窗口。Full 层的全局搜索由索引器完成,其主注意力也只读取选中的全局子集。候选池规定 Reindex 层选择之前的搜索范围,Selected Main KV 则是选择之后读取的数据;各解码器层共享的完整主 KV 缓存继续保留。搜索与读取路径,§2.3.1–2.3.2、Figure 4–5,pp.10–12
对于同一个 query/token,各 Reindex 层都在同一个候选池内独立重选。比如第 28 层可以选中候选池中未被第 24 层选入 Top-512 的位置。共享发生在本次 query 的后续解码器层之间,新的 query 会构建自己的候选池。跨层候选池与重新选择,§2.3.2,p.12
以一个百万 token 历史为例,较深层可以从 16,384 个候选中选择不同证据;第一个索引器漏掉的块,在本次 query 的后续解码器检索中便无法重新进入。后续索引成本对上下文长度有固定上界,首次全范围扫描仍然存在,编码器索引也未使用这项候选限制。因此全模型 decode 的渐近成本仍含随上下文增长的部分。
四位缓存:890 字节究竟由什么组成
报告把主 KV 的用途限定为存储后再反量化参与注意力,因此格式选择不必完全服从原生四位矩阵乘硬件。主 KV 采用 E2M1,每 16 个通道配置一个 E4M3 scale,省去 NVFP4 中第二级全局 scale;对 RoPE 之后的全部 512 个通道量化,包括旋转位置部分。该方案在后训练中引入量化感知训练(QAT)。索引器 query / K 延续 MXFP4,SWA KV 因对量化更敏感而保留 FP8。缓存格式与 QAT,§2.4.4,p.14
结合配置和参考代码可以重建全局 KV 的字节账本:
| 单个全局位置的保存内容 | 字节计算 | 字节数 |
|---|---|---|
| 主 KV latent,512 通道四位值 | 256 | |
| 主 KV scale,每 16 通道一个八位 scale | 32 | |
| 索引器 K,128 通道四位值 | 64 | |
| 索引器 K scale,每 32 通道一个八位 scale | 4 | |
| 合计 | 上述四项相加 | 356 |
编码器的三个源层各保存半个序列长度,解码器的一个源层保存完整序列长度,所以每个输入 token 对应的全局存储为:
这是根据已披露布局的本地演算,与报告给出的 890 一致;它没有额外乘以 query head 数,也没有把同一个 latent 重复算成独立 K、V 两份。按 1,048,576 个 token 计算,单序列全局 KV 约为 0.87 GiB。模型权重、SWA、临时激活、运行时缓冲、页表、对齐及并行副本均需另外计入。报告 §2.4.4、§4.2.1、参考代码 Indexer、Attention 与量化布局
SWA Bounded Replay:按状态的复用寿命安排保存与恢复
SWA 的窗口只有 128 个 token,但局部依赖会跨层累积。按报告的理论感受野估计,恢复
- 编码器恢复: 全局前缀 KV 命中、编码器局部 KV 缺失时,重放缓存前缀最后 128 个 token,再处理尚未缓存的后缀。重放段复用已有全局 KV,只重新生成 SWA;新增后缀才写入新的全局 KV 和 SWA。
- 解码器恢复: 每次 prefill 只把完整提示最后 128 个位置的编码器输出送入解码器,以重建解码器局部 KV。解码器全局 KV 已由编码器输出构造;恢复的局部状态只服务当前 decode,不进入前缀缓存。
例如,缓存命中了前 100,000 个 token,新增工具输出为 2,000 个 token,而局部缓存已过期。编码器从命中边界前 128 个位置开始恢复局部状态,再处理新增内容;原有全局前缀保持不变。解码器只处理整个新提示最后 128 个位置。这个例子也说明:缓存命中边界会影响恢复状态,继而影响新增后缀的 KV。 报告明确承认不同命中位置的结果不具备数学等价性,并在后训练中模拟解码器重放进行适配。两条恢复路径,§3.2.2,p.20
部署策略据此区分状态寿命。全局 KV 保留在长周期持久缓存中,作者配置至少 72 小时;编码器 SWA 使用约占各机器主机 DRAM 10% 的分布式内存池,只保留分钟级 TTL。局部状态缺失时可以低成本重建,因而无需随全局历史一起长期存放。报告称 V4 持久缓存中局部状态约占一半,移除这部分,再把全局部分压至原来的约四分之一,得到同类负载下约八分之一的持久容量。这一比例依赖原有负载、回合长度和缓存组成。持久缓存管理,§3.2.1,p.19
辅助结构如何补足容量和执行效率
Engram 扩展可查表的参数容量。 本模型额外配置 196B Engram 参数,均分到零起始第 1、14 层。对文本后缀的 2、3、4-gram,先进行 token 规范化,再按每阶 8 个哈希头查表;每阶共得到 2,048 维 embedding,由当前 hidden state 调制各残差分支的注入强度。查表地址只依赖 token,门控依赖上下文,两者分开后可以在前序主干计算期间预取表项。本次删除原 Engram 的短因果卷积,表和投影使用 FP8,表更新改用动量加 Sinkhorn 平衡。参考实现对图像位置关闭 Engram 注入。报告 §2.4.2、§3.1.3、Engram 原论文 §2、本版 Engram 与图像 mask
推理中的主机表预取并不意味着所有阶段都把 Engram 放在 CPU。训练时表按行切分,预取和梯度回传与视觉编码计算重叠;报告特别说明 RL rollout 的表常驻 GPU,以减少主机内存压力及碎片导致的失败。容量位置是运行阶段的配置,196B 查表参数仍然占用实际存储。Engram 系统实现,§3.1.3,p.18
Single-Pass mHC 改变一次依赖,消除残差的重复遍历。 mHC 保留四条残差流,输入混合系数原本由当前残差计算;必须等归约完成,才能再次读取残差并混合。新版让当前计算块使用前一块已经产生的输入混合系数:
于是同一块残差数据加载后,可以同时用于本次输入混合和下一次系数预测。部署用 Mega-mHC 融合残差更新、混合、系数预测、输入归一化及 FP8 转换,将该操作的激活读写量从原实现的
DSpark 把草稿长度选择交给接受率和执行成本。 三个草稿 Transformer 块一次产生五个位置的基础 logits,轻量 Markov head 描述草稿 token 间依赖,置信度头预测条件接受概率,再由调度器结合引擎吞吐曲线决定验证多长的前缀。五个草稿位置并不对应固定五倍加速。主干预训练时没有联合训练 MTP;预训练后先冻结主干训练 DSpark,后训练中继续更新 DSpark,但其目标的梯度不传入主干。DSpark 与梯度边界,§2.4.3,pp.13–14
从原生多模态预训练到可验证的任务环境
图像先经过从头训练的 DeepSeek-ViT,使用 2D-RoPE、线性 patch 投影、RMSNorm 和 SwiGLU。
主干从预训练起就混入图文数据,总计 45T token,纯文本与多模态数据的 token 比为 7:1;这个比例不等于纯文本 token 与图像 token 的比例。稀疏注意力从 64K 序列长度起训,在累计 34T token 时扩至 1M。batch 固定为约 100.6M token;视觉编码器在学习率衰减开始前冻结,最后归一化层和投影器保持可训练,衰减开始后才联合更新视觉编码器。数据整合与训练设置,§4.1–4.2
参数更新也按对象分工:线性矩阵主要使用 Muon,query / key 权重采用按头 Muon;归一化和其他非矩阵参数使用 AdamW;Engram 表、token embedding 和预测头使用 Nesterov 动量后交替进行行、列归一化的 Sinkhorn 更新。后者只保存动量,避免为大表保存 Adam 的两份矩状态;其行列归一化针对“token / n-gram 身份 × 隐藏特征”的矩阵结构。作者报告经验优势,未在本文给出匹配预算的完整优化器比较。优化器与 Algorithm 1,§2.5,pp.14–16
后训练沿用 SFT、RL、OPD 的既有范式,主要工作投入任务和环境。一个训练任务被组织为“问题、环境、验证系统”三元组,同时审核难度与正确性。通用 agent 环境从自愿返回的真实交互、工具接口和失败案例构造;代码任务从复杂工作会话和公开仓库出发,经过可运行性判断、任务与测试设计、隔离环境构建、多次试解、独立质检、修复及重新验证。代码测试同时包含目标变化的 fail-to-pass 项和既有行为的 pass-to-pass 项,任务在后续 RL 使用中继续接受轨迹审计。任务生产链,§5.1.1,pp.25–26
异步 RL 用样本完成事件维护并发:累计完成的样本数达到下一个 prompt 的 GRPO 分组大小,就分派该 prompt,不要求这些完成样本来自同一组。训练数据积累足够时暂停 rollout,训练后恢复。系统保存跨 checkpoint 轨迹的 KV 与专家路由,在训练中拼接各段真实采样时的路由;分别用数据集并发约束、启动阶段短样本处理、陈旧性限制和 token loss mask 缓解长度偏差与 off-policy 问题。最后以 40 多个、可以异构的教师在学生轨迹上提供全词表 OPD 监督,整合不同领域能力。异步 RL 与 OPD,§5.2,pp.30–32
这套调度维持的是长轨迹执行进度;跨 checkpoint 复用旧 KV 不具备“用最新参数重新计算整个前缀”的数值等价性。报告没有披露足以独立重建全套 RL 的任务量、总训练预算、所有奖励权重、陈旧性阈值和教师清单。任务和环境的重要性有运行结果支持,独立因果贡献仍需匹配训练预算的比较。
Reasoning effort:学习不同的推理长度代价
模型接收 1–100 的 effort 数值
附录用“额外推理的边际成功收益近似指数衰减”来解释这个惩罚形式:当最优点位于内部且惩罚未触及上限时,指数下降的 token 成本可产生随 effort 近似线性增加的偏好长度。该推导是局部奖励模型;随机生成、策略变化、多轮交互及惩罚截顶都会改变实际曲线。推导条件,Appendix C,pp.49–51
证据与结论
存储账本与执行依赖支持降本方向,生产速度仍需单独测量
全局 KV 的 890 字节可以由四个源层的数量、压缩率和量化布局重建;CED 提前结束大部分输入位置计算的依赖也明确。这些材料足以支持相应的缓存布局和执行成本判断。持久容量约八分之一则结合了 V4 部署中 SWA 约占一半的具体组成,不能作为所有缓存策略的固定比例。缓存布局与部署,§2.4.4、§3.2.1
报告 Figure 2 显示从 4K 扩到 1M,上下文长度增加 256 倍,单 token decode FLOPs 只增加约四分之一。但图中对 BF16、FP8、FP4 运算分别使用 1、0.5、0.25 权重。这是考虑精度权重的计算量曲线,不是统一硬件上的时间测量。本文也没有给出覆盖硬件、并发、输入输出长度、缓存命中率及网络搬运的完整服务吞吐—延迟曲线,因此不能由此推导四倍吞吐、八倍并发或整机成本同倍下降。Figure 2 与计数口径,p.5
近似重放、跨层复用、候选池限制和低精度共同启用后,作者报告能力良好,并说明内部测试中没有观察到系统性退化。但各项移除或替换后的独立损失、缓存边界压力测试及误差分布没有完整公开。证据支持这套联合配置已经取得较强结果,独立组件的能力代价与极端恢复边界仍待检验。重放说明,p.20;局限,p.37
基座能力提升有具体分布,知识与长上下文仍存在差距
下表选取报告内部统一评测设置下的基座结果;每行均使用报告相同的 few-shot 数与指标。
| 基座评测 | V4-Flash | V4-Pro | V4.1-Flash | 本项观察 |
|---|---|---|---|---|
| MMLU-Pro,5-shot EM | 68.3 | 73.5 | 74.1 | 接近 Pro 并略高 |
| SimpleQA-Verified,25-shot EM | 30.1 | 55.2 | 42.3 | 较 Flash 提升,仍低于 Pro |
| BigCodeBench,3-shot Pass@1 | 56.8 | 59.2 | 60.6 | 本配置代码成绩更高 |
| HumanEval,0-shot Pass@1 | 69.5 | 76.8 | 79.4 | 本配置代码成绩更高 |
| GSM8K,8-shot EM | 90.8 | 92.6 | 93.0 | 接近 Pro 并略高 |
| MGSM,8-shot EM | 85.7 | 84.4 | 80.2 | 低于两个前序模型 |
| LongBench-V2,1-shot EM | 44.7 | 51.5 | 45.2 | 与 Flash 接近,低于 Pro |
这些结果支持“部分知识、代码与数学能力达到或接近更大基座的水平”,同时保留 MGSM、SimpleQA 和 LongBench-V2 的边界。1M 上下文容量没有直接证明在百万长度下所有远程依赖都被可靠利用。完整基座结果,Table 1,p.24
内部保留语料上,V4-Pro → V4.1 的 BPB 分别为:内部文档 0.590 → 0.564,内部代码 0.1494 → 0.1443,学术材料 0.4677 → 0.4305。本地计算的相对下降约为 4.4%、3.4%、8.0%。这是三份未公开语料的语言建模结果,不能直接变成科研任务成功率。架构、数据、总训练量与参数组成同时变化,也无法据此单独归因于 CED 或 Engram。内部语料与 Figure 6,pp.24–25
参数比较还须保持口径:552B 指 backbone,此外有 196B Engram;报告所用约“三分之一 Pro 参数”的表述采用 backbone 对 backbone。8B / 16B 激活量必须随 prefill / decode 分开使用,不能给所有工作负载指定同一个平均压缩比。参数定义,§2.1,p.7
发布方 agent 评测进步显著,困难任务仍拉开差距
以下为报告 Table 3 的 Max effort 结果,数值为相应百分比;DeepSWE 使用 Resolved,其余所列使用 Pass@1。比较来自发布方汇总,本地未运行复测。
| 评测 | V4-Flash | V4-Pro | V4.1-Flash | Opus-5 Max |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 82.7 | 87.9 | 90.6 | 89.1 |
| Terminal-Bench 3.0 | 7.6 | 11.8 | 30.0 | 43.3 |
| Terminal-Bench 4.0 | 7.0 | 12.4 | 31.2 | 51.8 |
| DeepSWE v1.1 | 54.4 | 62.7 | 74.2 | 74.0 |
| AutomationBench | 37.7 | 43.2 | 54.8 | 50.3 |
| Agents' Last Exam | 25.2 | 25.7 | 31.8 | 28.6 |
| GPQA Diamond | 89.9 | 92.4 | 90.9 | 93.4 |
| Chartography,带工具 | — | — | 78.9 | 84.0 |
V4.1 相对 V4-Flash 在 DeepSWE 提高 19.8 个百分点,在 Terminal-Bench 2.1 提高 7.9 个百分点,后续更难版本也有较大提升;Table 3 同时显示其与领先闭源配置在 TB 3.0 / 4.0、视觉任务和部分纯推理项目上的差距。DeepSWE 的 74.2 对 74.0 只表示该表中的数值接近,缺少置信区间时不能据 0.2 个百分点建立稳定领先判断。主要结果,Table 3,p.33
评测中的代码 agent 主要使用 DeepSeek Harness Minimal 和 1M 上下文,DeepSWE 使用 mini-SWE;视觉 agent 使用 Claude Code 与 512K 上下文。代码与视觉 agent 设置为 temperature 1.0、top-p 0.95;报告对单轮推理评测写的是 temperature 和 top-p 均为 1.0。HLE 全集 36.8 与文本子集 39.1 是不同分母;ZeroBench 的 Pass@5 也不与 Pass@1 混比。模型、工具、框架和预算共同决定这些结果。评测设置,§5.3.1,p.32
作者将后训练收益主要归于数据和环境生产,Figure 7–8 展示累计 RL steps 增加时的成绩提升;曲线也混入上下文扩展、跨运行 checkpoint 合并和不同框架配置。它们支持持续扩大这套训练流程能够改善结果,尚未形成“环境工程的边际收益普遍超过算法研究”的受控因果证据。引言所称可完成超过 95% 现实任务,也未提供可审计的任务总体、样本分母和成功标准。RL scaling,pp.25–28;引言表述,p.6
同一个 checkpoint 的框架差距足以改变部署判断
报告固定模型、任务和采样配置,改变框架的系统提示、工具定义与交互逻辑,得到:
| 框架 | DeepSWE v1.1 Resolved | Terminal-Bench 2.1 Pass@1 |
|---|---|---|
| Claude Code v2.1.251 | 69.8 | 88.0 |
| Codex v0.147.0 | 65.6 | 84.1 |
| OpenCode v1.18.15 | 65.5 | 85.0 |
| Pi v0.84.2 | 66.2 | 86.1 |
| mini-SWE | 74.2 | 90.3 |
| DeepSeek Harness Minimal | 72.6 | 90.6 |
| DeepSeek Harness Standard | 70.5 | 85.8 |
| DeepSeek Harness PTC | 67.6 | 85.8 |
DeepSWE 最高与最低相差 8.7 个百分点,TB 2.1 相差 6.5 个百分点。DeepSWE 每任务 8 次采样,TB 每任务 3 次,均为 1M 上下文、最多 500 次模型生成轮,temperature 1.0、top-p 0.95;多次采样没有把表中指标改成“多次尝试只要一次成功”的 Pass@8 / Pass@3。结果说明模型在多个框架中都具备能力,同时框架选择仍有实质影响。表中的 Codex、Claude Code 是运行框架,本行所有实验的模型均为 V4.1-Flash。Table 4,p.35;框架版本,Appendix B.1
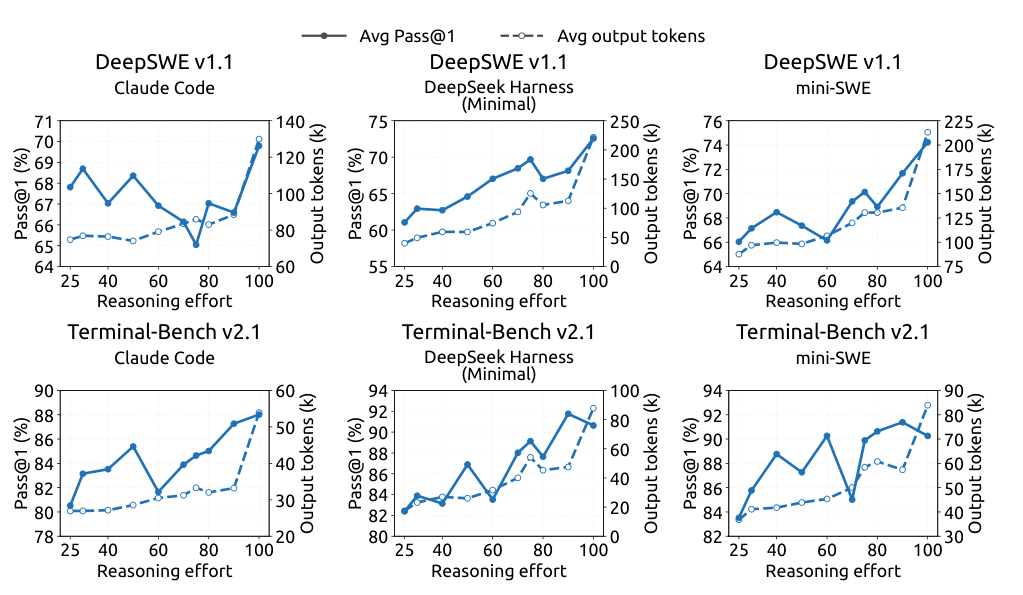
effort 也须按框架校准。正文选定设置中,effort 25 → 100 时,DeepSWE 为 66.0 → 74.2,TB 2.1 为 82.4 → 90.6,代价是约 2.5 倍输出 token;但附录同一 checkpoint 的跨框架曲线存在准确率平台和回落。可以判断 effort 控制了总体计算投入,不能保证每个框架、任务、相邻档位的成功率单调上升。Figure 9,p.35;Appendix B.2、Figure 11,pp.48–49
多 agent 是有希望的初步结果,证据限定在实际协议内
Agent Team 训练把任务表现、鼓励协作的奖励和派生时延惩罚组合起来。派生时延将执行事件及协作依赖表示为有向无环图,用固定 prefill / decode 速率换算 token 成本、加入实测工具时间,再计算关键路径。这样的训练信号鼓励能缩短依赖链的并行工作,同时降低服务排队噪声对奖励的影响。多 agent 训练,§5.3.5,p.36
在 ProgramBench 中,作者筛选出参考解通过率至少 95% 的 172 个任务,每任务最多 3 次 rollout;Almost@1 统计单条 rollout 达到至少 0.95 测试分的比例。8 小时截止时,所报告多 agent 配置为 30.04%,单 agent 为 20.39%;FrontierSWE v2 的公开 no-GPU 子集在 20 小时截止时 Mean@5 为 32.90 对 28.20。任务选择、指标与 Figure 10,p.36
这些实验匹配墙钟截止时间,未匹配总 token、并行设备或总计算预算,而且选择了已观察到的较强配置。它们支持在所测协议下利用并行协作提高限时成绩;不能识别纯粹增加代理数的独立效应,也不能直接推广至未筛选的完整 ProgramBench 或包含 GPU 的任务。
抽象与迁移
将“形成可复用历史”与“读取历史进行新计算”拆开
有直接依据的认识是:高层计算每次都需要历史信息,并不必然要求每层单独保存一份历史。CED 将全局表示集中在较早的计算边界,CSA2 保留各层 query 和局部更新,使计算深度与全局 KV 副本数部分解耦。
对应到反复读取大量仓库文件的代码 agent,输入文件与工具输出对应编码对象,生成补丁对应解码阶段。若新输入占总负载较大、全局表示已足以支持后续读取,编码阶段节省会更明显;若主要开销来自长输出、工具执行或队列等待,prefill 改造对端到端时延的影响会减小。前述不同输入长度的计数给出了这个预测的来源。这是架构设计上的条件性迁移,直接套用到每层都必须生成独立 KV 的既有 checkpoint 需要额外训练验证。
近似重建把缓存边界变成模型行为的一部分
SWA 重放说明,状态是否需要长期保存,取决于保存成本、未来复用概率、恢复代价和允许误差。全局表示承担长周期复用,局部状态通过短期缓存和有限计算恢复;较低的恢复代价使不同 TTL 成为可行设计。
可迁移到可暂停 agent 的前缀恢复设计,但应把命中边界纳入验证变量。待验证实验可以固定输入和后缀,逐步移动命中位置,比较完整前向、精确窗口恢复、128-token 近似恢复;同时记录后缀 logits 差异、任务成功率和连续多次恢复后的变化。若答案依赖边界附近的精确顺序、逐字符复制或被截断的局部组合,近似误差可能更明显。持续增长的误差、边界相关失败或全局检索不能补回的信息,会否定“该恢复长度足够”的迁移假设。
共享表示与共享候选池分别产生容量和召回约束
CSA2 的 Reindex 保留了在相同历史表示中改变关注位置的能力;分层索引则进一步限定所有深层搜索必须落在第一个候选池中。二者对表达和召回的影响不同。
在跨文档证据组合中,若浅层索引能保留后续所需的多个证据块,后续 query 可以低成本重新组织这些信息;若后续才显现的条件对应一个初始低分块,所有后续 Reindex 都无法选到它。待验证比较应同时测量候选池召回与最终任务质量,并与不限制候选池的版本对照。只观察最终 Top-512 数量或整体成绩,无法区分共享 KV 的损失和首次筛选的损失。
可验证任务的生产规模必须与验证器质量共同增长
本报告具体可迁移的关系是:任务、可执行环境和验证系统共同定义 RL 的学习信号。环境构造扩大覆盖,独立试解和质检暴露描述—测试不一致,后续训练轨迹又成为重新审计任务的材料。扩大其中一项会改变另外两项的失效方式。
对于自动构造仓库修复任务的训练流程,可对应保留行为测试、目标功能测试、参考解隔离和失败轨迹审核。若增加任务数时验证错误率上升,或 agent 能通过改变评测环境提高奖励,成功率增长就无法直接解释为目标能力增长。该报告提供了这条工程路径与失效观察,尚未给出验证器错误率随规模变化的定量规律。
effort 和协作规模需要按同一任务成本校准
同一个 checkpoint 的框架差距和 effort 非单调曲线表明,部署选择应考察“模型、框架、推理档位、任务分布”的组合。可测试先以较低投入处理常规任务,再在可观察失败或验证不充分时增加投入;这里的升级策略是待验证方案,报告没有直接测过它。
若比较单 agent 与多 agent,应同时约束截止时间和总 token / 计算,再观察复杂任务收益是否保留。任务容易分解时,依赖图关键路径可能缩短;任务高度串行、共享文件冲突频繁或验证必须集中完成时,更多协作可能增加等待和总成本。该预测来自报告采用关键路径时延奖励的具体设计。
Source
- Workflow version: v3
- Material type: technical-report
- Analysis modules: model-report, system, experiment
- Canonical source: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf
- Title: DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
- Authors: DeepSeek-AI(团队署名);Appendix A 中已核验并复用已有档案的成员包括 Xin Cheng、Wangding Zeng、Damai Dai、Xingkai Yu、Zhenda Xie 和 Wenfeng Liang。完整名单见附录。
- Responsible organization: DeepSeek-AI
- Affiliation: 团队署名为 DeepSeek-AI;附录 A 列出 Research & Engineering 与 Business & Compliance 成员,未提供逐人论文时机构映射。
- Published / updated: 2026-09-10 正式发布;模型仓库当日创建。所读仓库 revision 最后更新时间为 2026-09-10 06:25:21 UTC。
- Version / revision read: Hugging Face revision
fb2764a5cf321eaa5070ca8f9e892818f477c16d;固定 PDF、同 revision 的模型卡、配置、评测说明和参考推理代码。PDF 共 51 页,SHA-256 为ba68e2e40408125ae6d2f63a9a241b61c73910691c74ec1a2a7023c851eac08d。 - Accessed: 2026-09-10
- Reading scope: 已读正文 §1–6(pp.4–37)、附录 A–C(pp.46–51),核对 Figure 3、4、5、6、9、11 和 Table 3 等原始版面;参考文献用于定位 YOCO、Engram 等必要前作。已读同 revision 的 README、两份 config、evaluation/README、inference/README;选读 inference/model.py 的 Engram、索引器、注意力、mHC 与主前向路径。另核验官方更新日志、SGLang 部署文档及适配 PR、vLLM 适配 PR。未运行权重、训练或 benchmark;完整训练数据、生产服务栈和若干消融未披露。
- Key figure decision: include
- Key figure rationale: 总体图和三种 CSA2 模式用于核对跨层数据依赖;分层索引图用于区分共享候选位置与各层最终选择;effort 原图用于呈现不同框架下的性能回落与预算变化。
- Review status: page-type=not-checked; match-confidence=not-applicable; observed-at=2026-09-10; venue-status=unknown
- License: 模型仓库及权重的 MIT 许可。
发布与部署补充
以下补充按 2026-09-10 的发布状态记录,核心数值以固定 PDF 为准;检索定位结果均回到原始网页或代码核验。
官方 API 名称已经变化。 更新日志确认 V4.1-Flash 正式发布,调用名为 deepseek-flash;旧的 Flash 和 Vision Exp 名称暂时重定向到新模型。官方另宣布 9 月 14 日北京时间 12:00 后,将 deepseek-v4-pro 暂路由至 V4.1-Flash,直到未来 V4.1-Pro 发布。因此仅保存 API 模型别名不足以确定复现实验的模型身份,还需要调用时间及服务方版本信息。2026-09-10 官方更新日志
发布材料存在两处需要保留的差异。 固定 PDF Table 3 与官方日志的 NL2Repo-Bench 均为 65.4,同 revision 模型卡为 64.0,原因未说明;本笔记不合并为一个无条件分数。模型卡把 instruct 采样统一写为 top-p 0.95,而 PDF §5.3.1 将单轮推理设为 top-p 1.0;正文按 PDF 的分任务协议记录。固定模型卡、PDF 评测设置与表格
| 材料或实现 | 核验到的状态 | 对复现和部署判断的影响 |
|---|---|---|
| DeepSeek 最小推理 | 提供权重转换、模型前向与普通自回归生成;README 明确说明是可读参考实现 | 主前向遍历全部层;索引器先生成全范围分数再做候选 mask。它体现模型计算语义,不能用来确认 CED 的 prefill 跳过或生产索引器的复杂度收益 |
| SGLang | 当日部署文档已发布,使用 dev-dsv41 / dev-dsv41-mi35x 预览镜像;文档明确尚未进入正式 release |
文档提供部署配方,适配主 PR 当次核验仍未合并;有配方不等于所有平台、组合和性能已稳定验证 |
| vLLM | 当日已存在模型适配 PR #56201 和 SWA bounded replay PR #56205,当次核验均未合并 | 开发中的支持可以确认;正式 release 可用性和完整服务收益尚未由这些 PR 证明 |
| DeepSWE 复现材料 | 固定了 Pier 和任务仓库 commit,并给出 mini-SWE / dsh-minimal 运行说明及适配 patch | 为外部复测提供了具体起点;本次未执行,也未把命令说明当作独立复现结果 |
来源:参考实现说明、主前向路径、索引器路径、SGLang 部署文档、SGLang 文档 PR #38802、SGLang 模型 PR #38798、vLLM 模型 PR #56201、vLLM 重放 PR #56205、固定版 DeepSWE 复现说明。PR 状态核验时间为 2026-09-10 15:06(UTC+8)。
SGLang 的补充尤其有助于理解生产条件:解码器窗口重放为显式启用项,不支持 prompt logprobs,且不与完整 prefill 数值等价;预览版还有 prefill CUDA graph、DP attention 等组合限制。文档说明当前后端不保证跨 batch 组成的逐位一致性,并拒绝 deterministic-inference 选项。DSpark 的高吞吐配方会关闭投机,说明草稿验证收益依赖批量与实际接受率;文档同时限制 PD 分离与投机组合。以上均为所读预览版声明,本地未做运行验证。SGLang 架构限制、配置与 DSpark / PD 说明
本次检索未取得可以与正式 V4.1 权重及同一评测协议对应的第三方完整基准复测。框架适配 PR 中的局部分数与发布前 beta 的使用反馈,均不足以替代这种证据;因此本文主要成绩保留发布方报告属性。
Model Summary
下表合并报告 §2 / §4.2 与固定版配置。B 表示十亿参数;“总量”与“每 token 激活量”分开记录。
| Field | Value |
|---|---|
| Architecture | 原生图文 MoE;CED 因果编码器 + 解码器,CSA2 / SWA,Single-Pass mHC,Engram,DSpark |
| Total Parameters | 官方报告 552B backbone + 196B Engram;两项合计约 748B。辅助模块的独立参数账本未单列,不把量化张量元素数当作精确参数总数 |
| Activated Parameters | Prefill 约 8B / token;decode 约 16B / token;prefill 窗口重放和视觉编码另有开销 |
| Number of Layers | 主干 40,编码器 20 + 解码器 20;DSpark 另有 3 个块 |
| Number of Dense Layers | 主干 FFN 中为 0;40 层均使用 MoE |
| Attention-Layer Composition | 2 层纯 SWA + 38 层 CSA2/SWA;全局分支共 4 Full、4 Reindex、30 Reuse |
| Model Hidden Dimension | 5120 |
| Attention Hidden Dimension | 每头 512;全部 query 头投影维度为 |
| Number of Attention Heads | 主 query heads 64,共享 KV latent;索引器 query heads 32、每头维度 128 |
| Attention Output Projection | 8 组,每组中间输出维度 1024 |
| MoE Hidden Dimension (per Expert) | 2304 |
| Number of Experts | 每层 384 个路由专家,另有 1 个共享专家 |
| Selected Experts per Token | 每 token 选 6 个路由专家,另计算共享专家 |
| Number of Shared Experts | 每层 1 |
| Vocabulary Size | 129280 |
| Context Length | 1,048,576 token;预训练初始 65,536,后扩展 |
| Attention Mechanism | CSA2 全局分支 + 128-token SWA;编码器压缩率 2、解码器压缩率 1;Top-512;解码器后续索引最多搜索 16,384 个候选 |
| Activation Function | SwiGLU,clamping 阈值 10 |
| Engram | 196B,两个模块;2/3/4-gram,每阶 8 个 hash heads、2048 维;每头表约 16M 项 |
| Vision Encoder | DeepSeek-ViT,32 层,hidden 1024,16 heads,patch 14,2D-RoPE,3×3 pixel-unshuffle;两层 MLP 投影至语言主干 |
| Parameters of Vision Encoder | 未单独披露 |
| Quantization | 发布配置为主体 FP8、专家 FP4,相应量化线性层的激活采用动态 FP8;Engram 表及投影 FP8。主 KV 为 E2M1 + 每 16 通道一个 E4M3 scale,后训练引入 QAT;索引器使用 MXFP4,SWA KV 保留 FP8。专家权重的 QAT 配方未在本报告单独展开 |
| Modality | 图像、文本输入;自回归文本输出 |
配置来源:HF config.json、inference/config.json、报告 §4.2.1,p.22。
作者与跨论文关系
论文以 DeepSeek-AI 团队署名。附录 A 按名字字母序分别列出研发与业务合规成员,星号表示已离队人员;这种排序不提供第一作者、共同一作或各模块负责人的依据。成员列表中存在重复的 Xinyu Yang、Yao Li 和 Zhixuan Chen,逐人身份不能仅凭姓名唯一确定。作者名单,Appendix A,pp.46–47
结合附录和已有 DeepSeek 作品记录,可复用本站的 Xin Cheng、Wangding Zeng、Damai Dai、Xingkai Yu、Zhenda Xie 和 Wenfeng Liang 档案;未依据附录给同名的其他机构研究者建立新关联。本篇未扩展个人资料,也未从成员重叠推断具体模块归属。
与已有笔记的可核验联系包括:
- DeepSeek-V4 提供 CSA/HCA、mHC 和多领域后训练的直接前序背景;V4.1 改为纯 CSA2,并改变 prefill 与持久缓存路径。
- Engram 是报告明确采用的条件记忆模块;本版落实了大表集成,删除短卷积并更换大表优化器。
- DSpark 是报告明确采用的草稿与置信度调度设计;本版说明了其独立预训练与后训练梯度边界。
- IndexCache 是报告讨论的跨层位置复用前作;CSA2 同时共享主 KV 与索引器 K,并增加重新检索层。此处关系来自本报告的直接引用,不把“同为索引复用”视为所有方法等价。